Ollama z Open WebUI na 2 x RTX 3060 12 GB
Przetłumaczone automatycznie z angielskiego. Przeczytaj oryginał
Ollama z WebUI na 2 „mocnych” GPU daje wrażenie jak komercyjne GPT dostępne online
Myślałem, że Exo wykona zadanie i wykorzysta oba moje serwery laboratoryjne. Niestety nie działa na Linux/NVIDIA w mojej konfiguracji i według oficjalnej dokumentacji. Wróciłem więc do Ollamy i uznałem ją za świetną. Mam 2 x NVIDIA RTX 3060 z 12 GB VRAM każda, co daje łącznie 24 GB, pozwalające uruchomić Gemma3:27b lub DeepSeek-r1:32b.
- Gemma3:27b zajmuje łącznie około 16 – 18 GB VRAM GPU
- DeepSeek-r1:32b zajmuje łącznie około 19 GB VRAM GPU
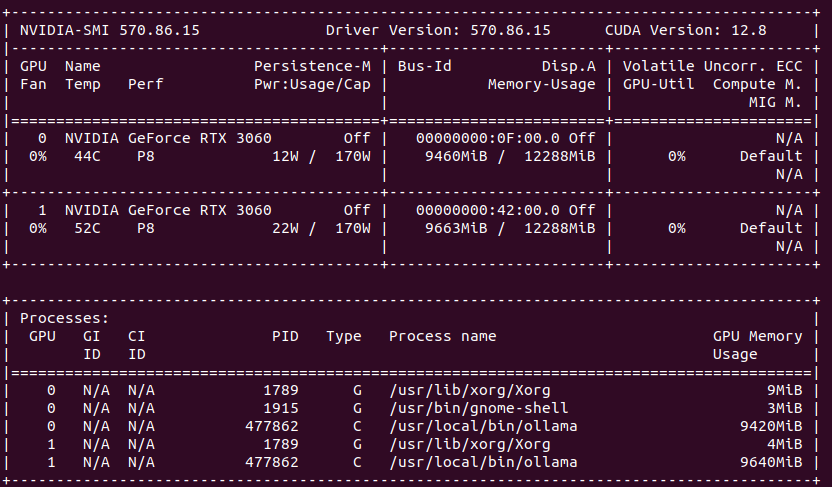
Ollama potrafi wykorzystać oba GPU w moim systemie, co widać w nvidia-smi. O tym, jak uruchomić Ollamę w Dockerze z akceleracją GPU, możesz przeczytać w moim poprzednim artykule.
Dlaczego więc uruchamianie na wielu GPU jest ważne? #
Mając w systemie więcej dostępnego VRAM, możesz uruchamiać większe modele, ponieważ wymagają one załadowania danych do pamięci karty graficznej w celu przetwarzania. Jak wspomniałem wcześniej, próbowałem też z Exo oraz vLLM, ale tylko Ollama obsługuje to bezproblemowo i bez żadnych komplikacji. Niestety Ollama, o ile mi wiadomo, nie obsługuje rozproszonej inferencji. Prace nad tym trwały już w listopadzie 2024 roku, jednak nie jest jasne, czy trafi to do głównej dystrybucji.
https://github.com/ollama/ollama/issues/7648
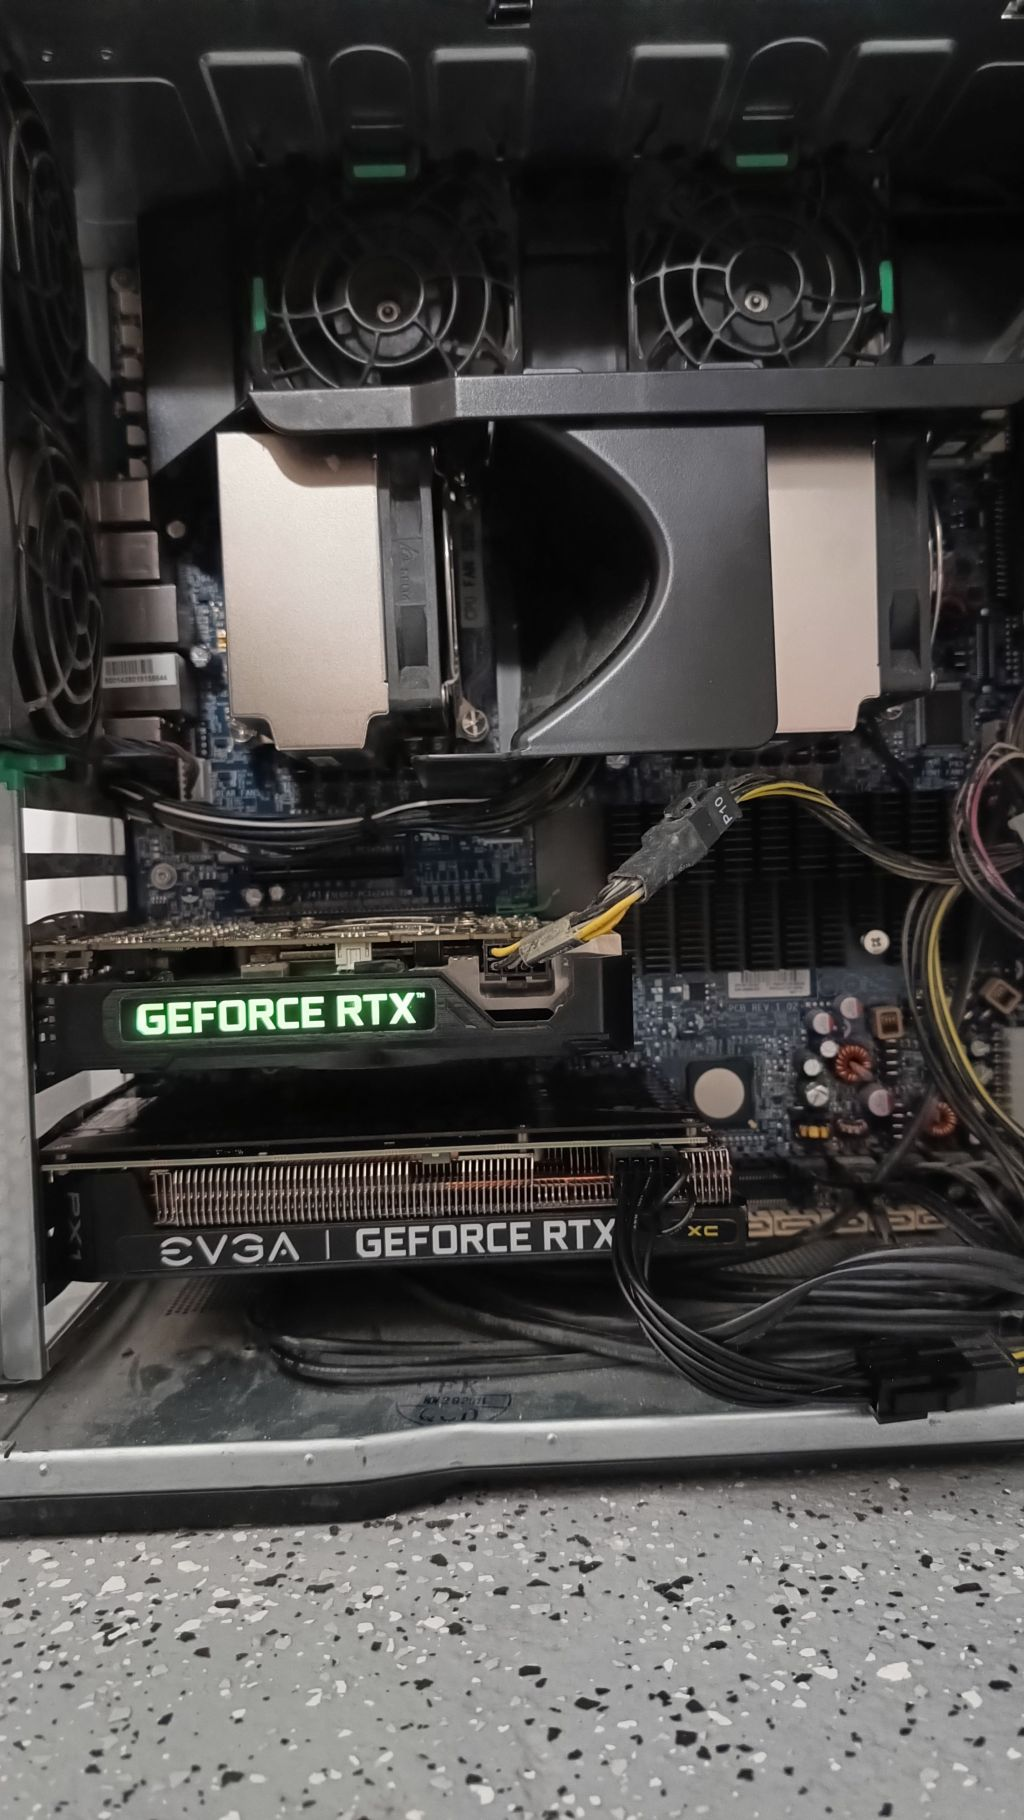
Uruchamianie więcej niż jednego CPU i GPU wymaga również mocnego zasilacza. Mój ma 1100 W i obsługuje 2 procesory Xeon, do 384 GB RAM oraz co najmniej 2 pełnowymiarowe, w pełni zasilane GPU. Na biegu jałowym pobiera około 250 – 300 W. Przy pełnym obciążeniu GPU pobiera 560 – 600 W.
Czy mogę zainstalować więcej niż dwa GPU? #
Tak, można. Jednak w moim komputerze laboratoryjnym nie mam więcej niż 2 wysokomocowe sloty PCI-E, więc kolejna karta może mieć zbyt małe zasilanie. Mimo to jest to dość ciekawa rzecz do sprawdzenia w najbliższej przyszłości.
A co z Open WebUI? #
Zamiast korzystać z wiersza poleceń Ollamy, pod względem produktywności lepiej użyć interfejsu webowego o nazwie Open WebUI. Można go uruchomić z kontenera Docker w następujący sposób:
sudo docker run -d --network=host -v open-webui:/app/backend/data -e OLLAMA_BASE_URL=http://127.0.0.1:11434 --name open-webui --restart always ghcr.io/open-webui/open-webui:mainNastępnie WebUI jest dostępne pod adresem 127.0.0.1:8080.
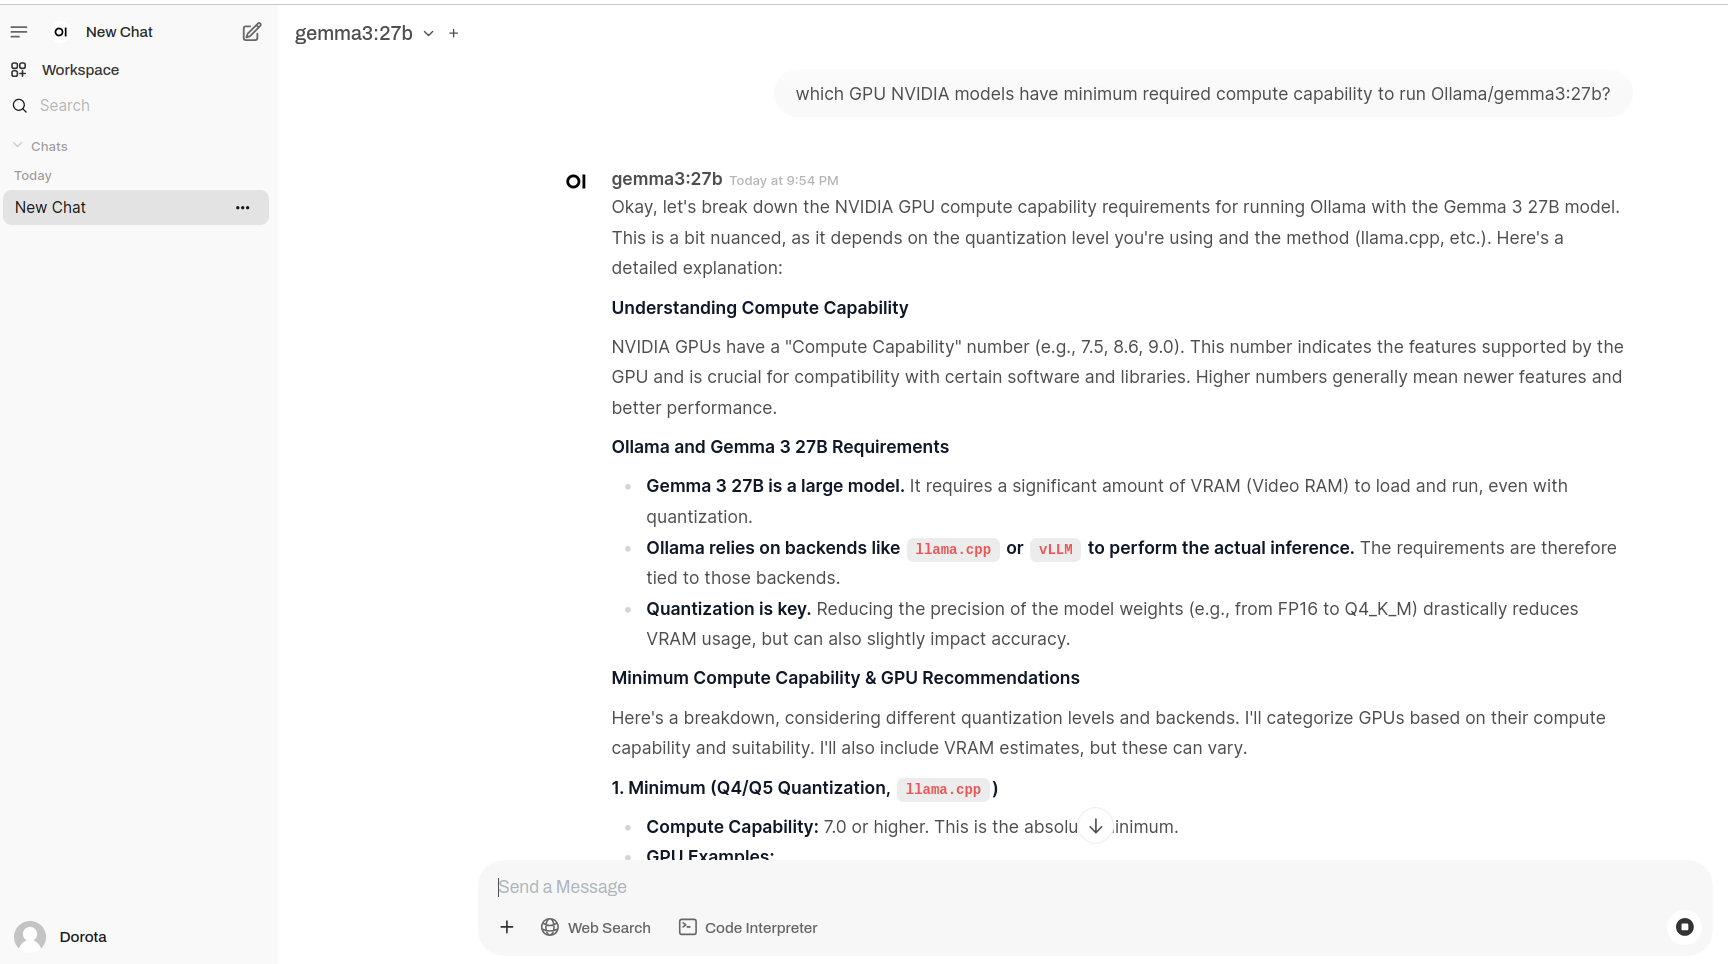
Działanie side-by-side #
Pozwala zadawać pytania modelom w trybie porównania side-by-side.
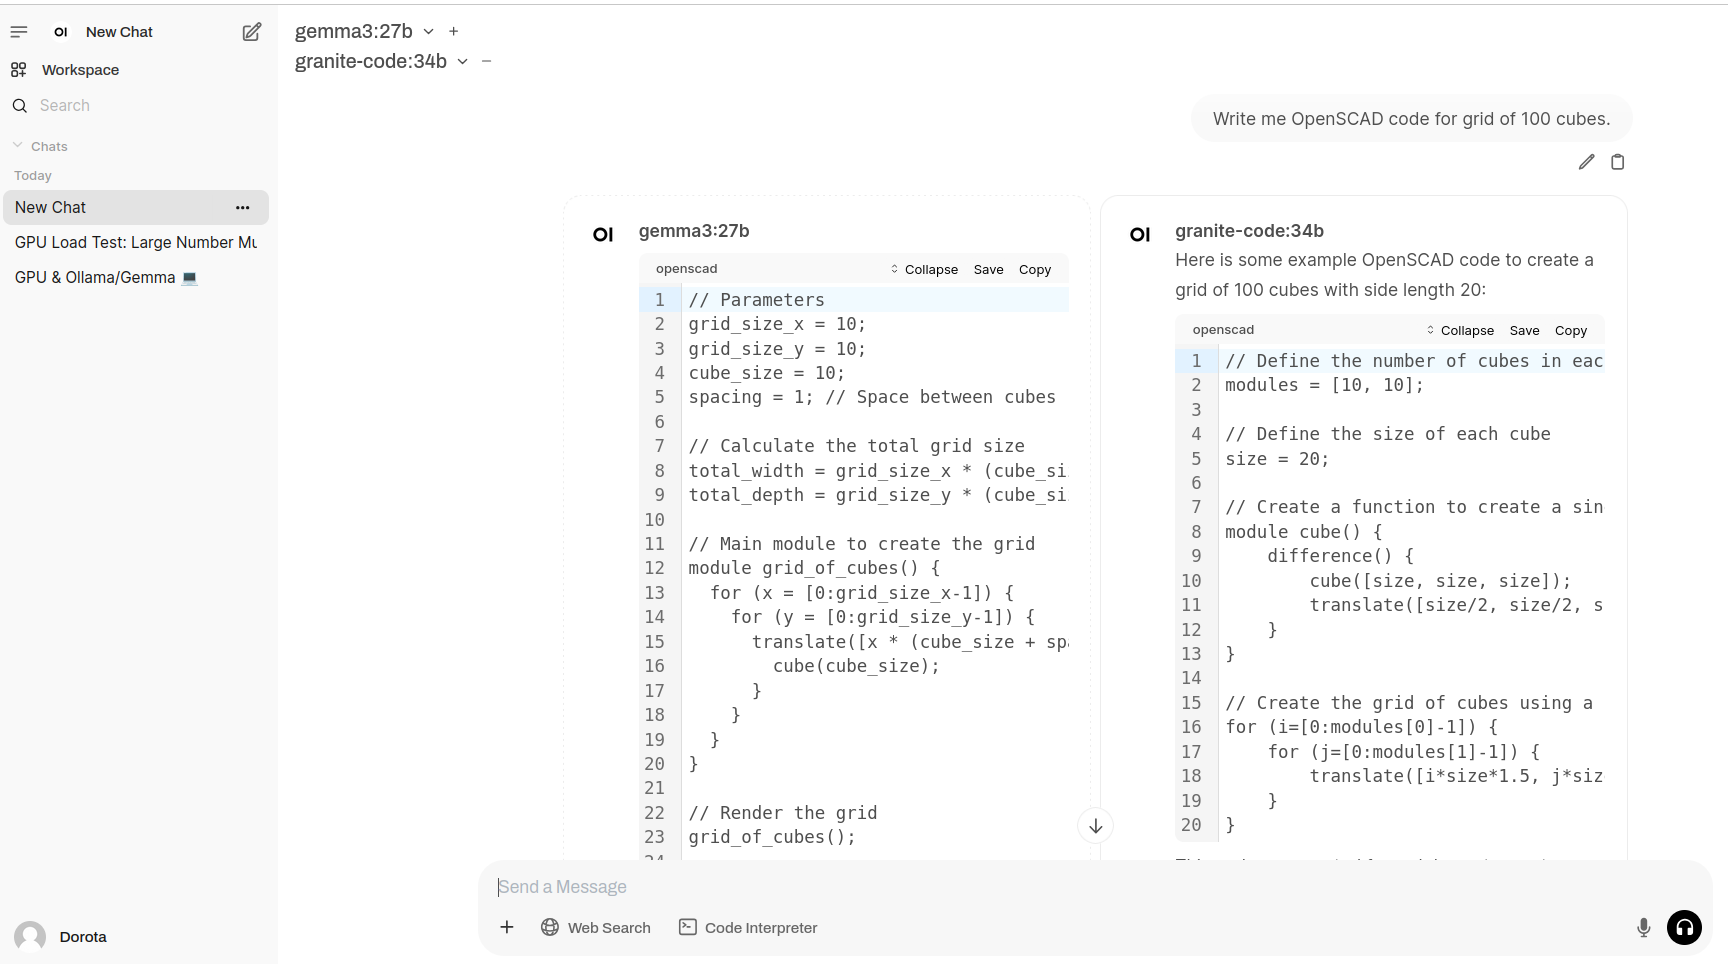
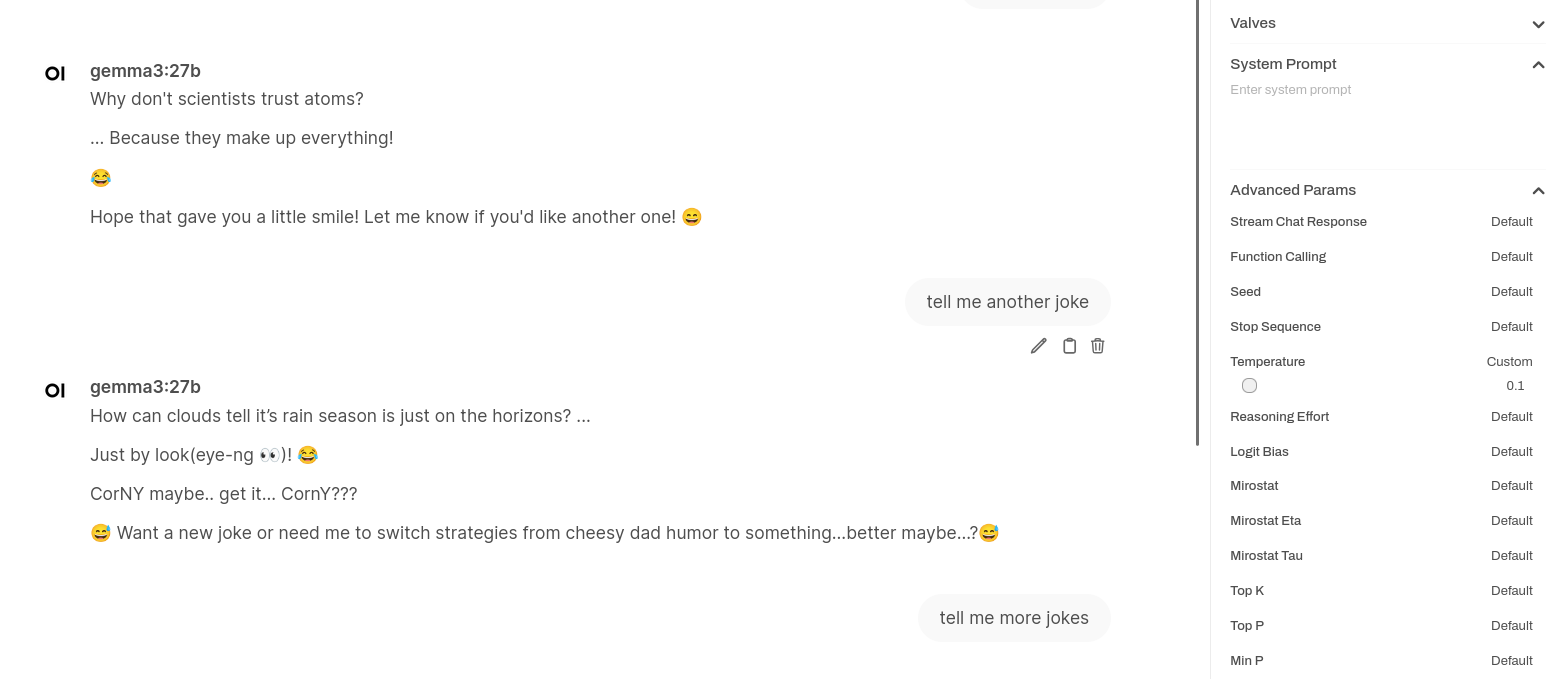
Parametryzacja #
Za pomocą WebUI możesz modyfikować parametry inferencji (parametry zaawansowane).
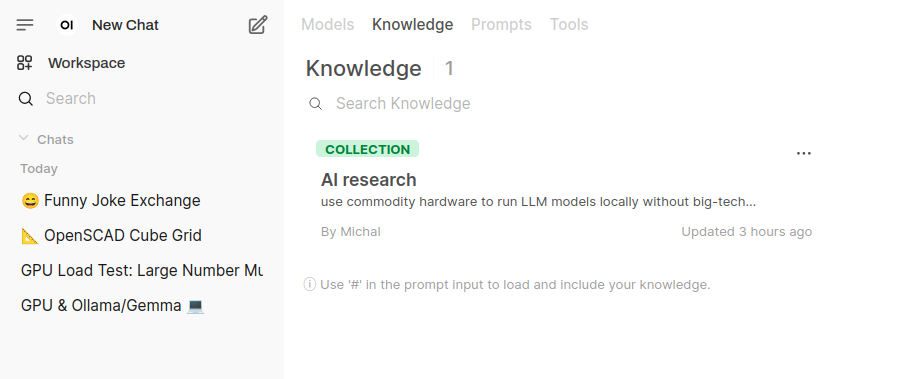
Baza wiedzy/kontekst #
Możesz zbudować własny kontekst wiedzy, do którego dodajesz wpisy wiedzy. Prawdopodobnie przydatne przy tworzeniu niestandardowych chatbotów.
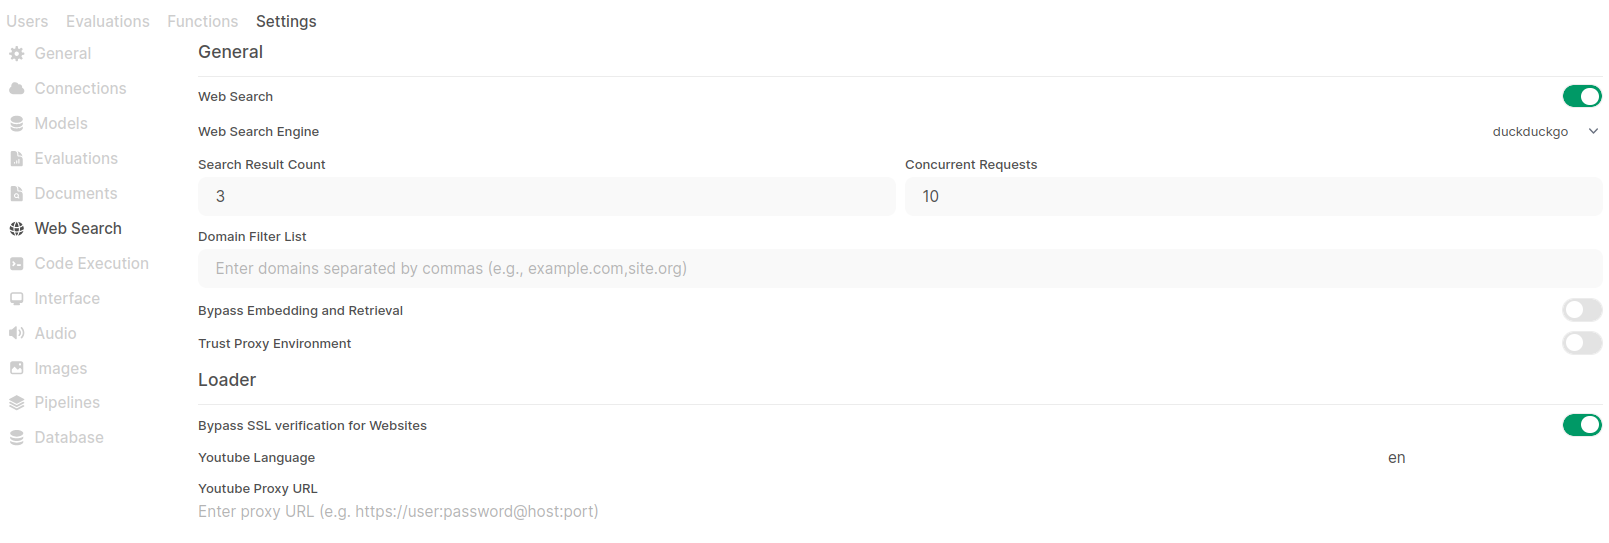
Wyszukiwanie w sieci #
Dostępna jest też funkcja wyszukiwania w sieci. Możesz zdefiniować preferowaną wyszukiwarkę.
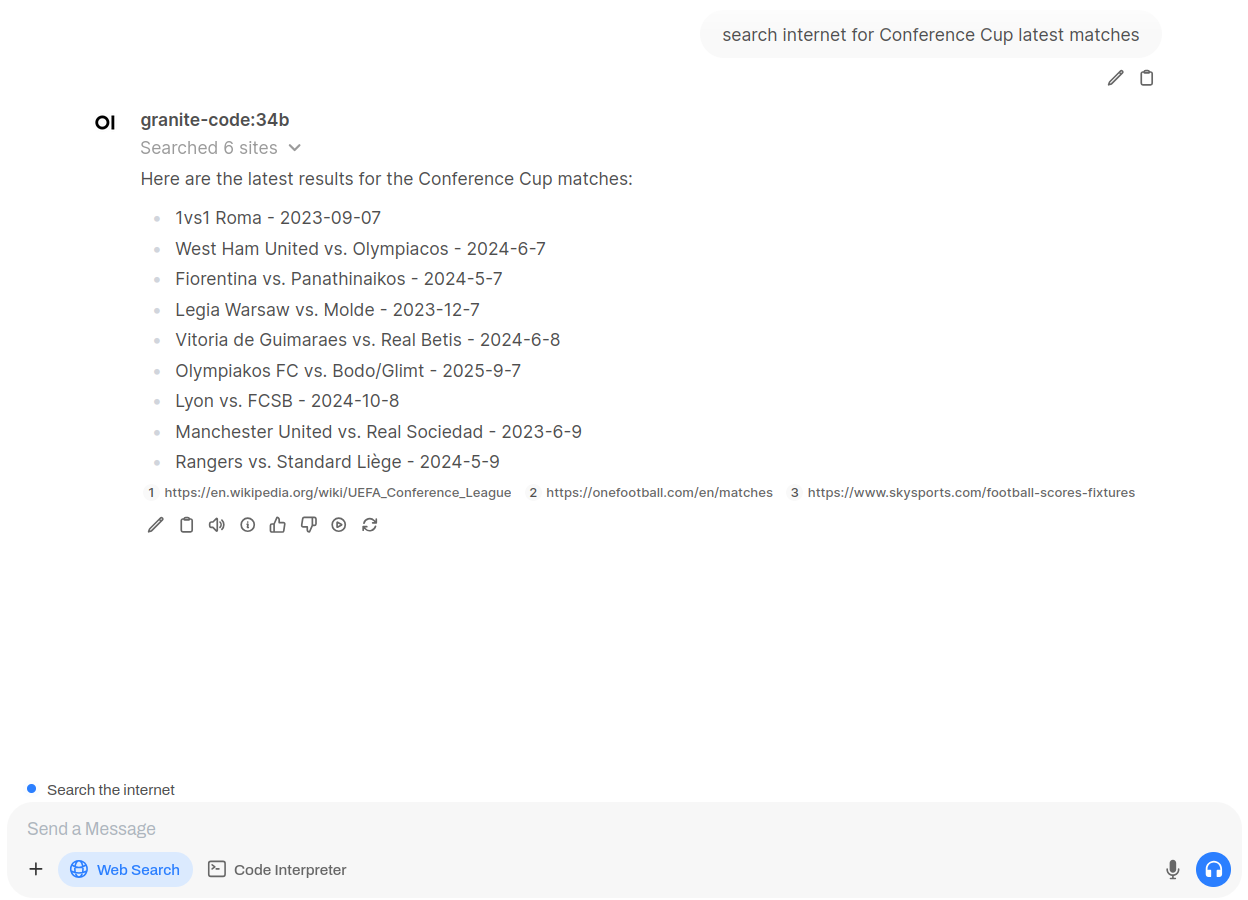
Po skonfigurowaniu rozpocznij nowy czat i włącz wyszukiwanie. Przeszuka internet w poszukiwaniu potrzebnych informacji. Choć wygląda to zabawnie:
Podsumowanie #
Możesz używać zwykłego, konsumenckiego sprzętu do uruchamiania lokalnych modeli LLM z Ollamą, nawet tych znacznie bardziej zasobożernych, łącząc wiele GPU w swojej maszynie. Rozproszona inferencja z Ollamą i Exo wymaga jeszcze trochę pracy. Będę szukał kolejnych narzędzi w tym rozległym morzu możliwości.