Generowanie obrazów za pomocą Stable Diffusion, Gemmy i WebUI na GPU NVIDIA
Przetłumaczone automatycznie z angielskiego. Przeczytaj oryginał
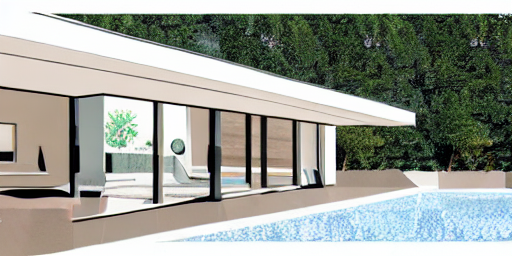
Z Ollamą w parze z modelem Gemma3, Open WebUI z RAG i wyszukiwaniem, a na koniec Automatic1111 z Stable Diffusion możesz mieć w domu całkiem kompletny zestaw funkcji AI w cenie 2 konsumenckich GPU i trochę prądu z domowego gniazdka.
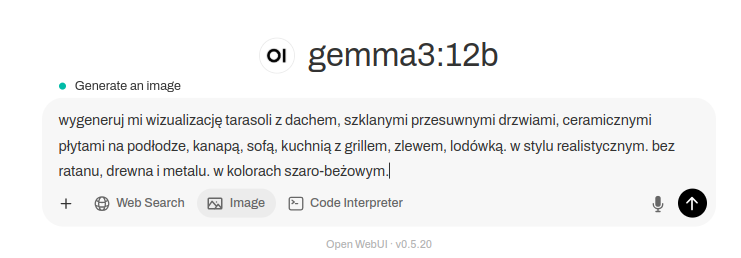
Przy 500 iteracjach i rozmiarze obrazu 512×256 wygenerowanie odpowiedzi zajęło około minuty.
Bawi mnie to, że można generować obrazy technikami AI. Próbowałem już kiedyś Stable Diffusion, ale teraz, z pomocą Gemmy i integracji z Automatic1111 w WebUI, jest to cholernie proste.
Krok po kroku #
- Zainstaluj Ollamę (Docker), pobierz jakieś modele
- Uruchom Open WebUI (Docker)
- Zainstaluj Automatic1111 ze Stable Diffusion
Wymagania wstępne #
Informacje o tym, jak zainstalować i uruchomić Ollamę i OpenWebUI, znajdziesz w moim poprzednim
Automatic1111 ze Stable Diffusion #
Stable Diffusion to model dyfuzji latentnej, pierwotnie stworzony na niemieckich uniwersytetach, a później rozwijany przez Runway, CompVis i Stability AI w 2022 roku. Automatic1111, również powstały w 2022 roku, to nakładka na Stable Diffusion, która pozwala korzystać z niego w bardziej przyjazny dla użytkownika sposób. Open WebUI potrafi zintegrować się z Automatic1111, wysyłając żądania tekstowe do jego API. Aby zainstalować go na Ubuntu 24, trzeba zainstalować Pythona 3.10 (preferowany) zamiast dostarczanego z systemem Pythona 3.12:
sudo apt install git software-properties-common -y
sudo add-apt-repository ppa:deadsnakes/ppa -y
sudo apt install python3.10-venv -y
git clone https://github.com/AUTOMATIC1111/stable-diffusion-webui && cd stable-diffusion-webui
python3.10 -m venv venv
./webui.sh
Jak widać, używamy venv. Jeśli Twoje Ubuntu ma tylko Pythona 3.11, to możesz śmiało z niego skorzystać. Uruchamiam Automatic1111 z kilkoma dodatkowymi parametrami, które pomagają mi w debugowaniu:
./webui.sh --api --api-log --loglevel DEBUGIntegracja z Open WebUI #
Przejdź do ustawień administratora i poszukaj „Images”:
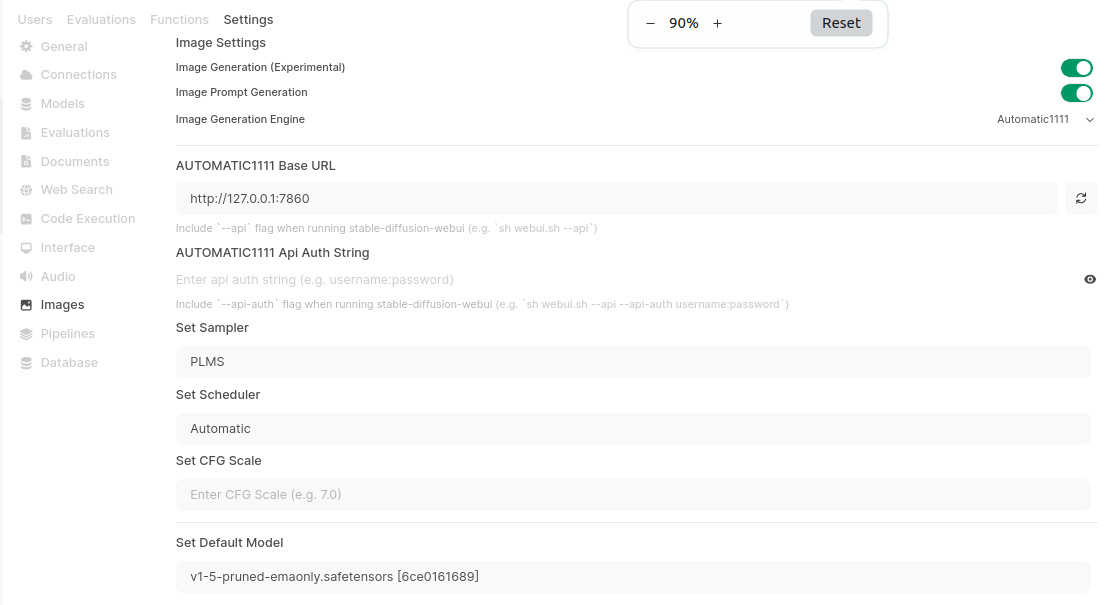
Włącz generowanie obrazów i generowanie promptów, a jako silnik wybierz Automatic1111. Wpisz Base URL, który domyślnie powinien mieć postać http://127.0.0.1:7860, jeśli uruchamiasz WebUI i Automatic1111 na tej samej maszynie. Dalej są sampler, scheduler, CFG scale i model.
Ostatnie dwa parametry uważam za najważniejsze z perspektywy użytkownika. Są to rozmiar obrazu i liczba kroków. Ten drugi ustawia liczbę iteracji dyfuzji, czyli przetwarzania szumu. Im więcej ustawisz, tym dłużej trwa generowanie. Rozmiar obrazu również wydaje się mieć związek z efektem końcowym, bo określa, jak duży ma być wynik.
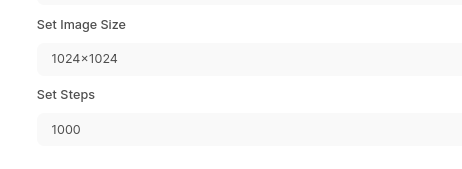
1000 iteracji #
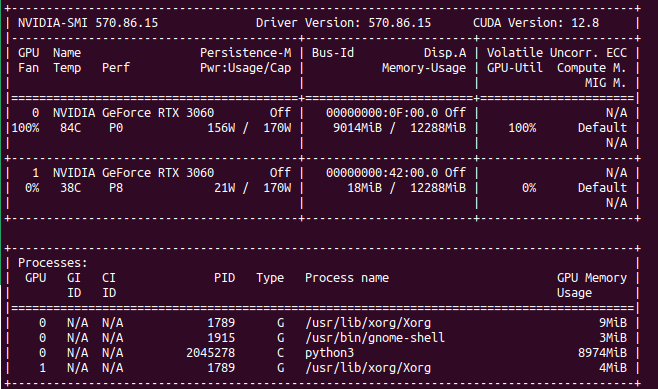
Ustawiłem liczbę iteracji na 1000 i poprosiłem o wygenerowanie wizualizacji. Trwało to około 30 minut, a zużycie VRAM urosło do 9 GB.

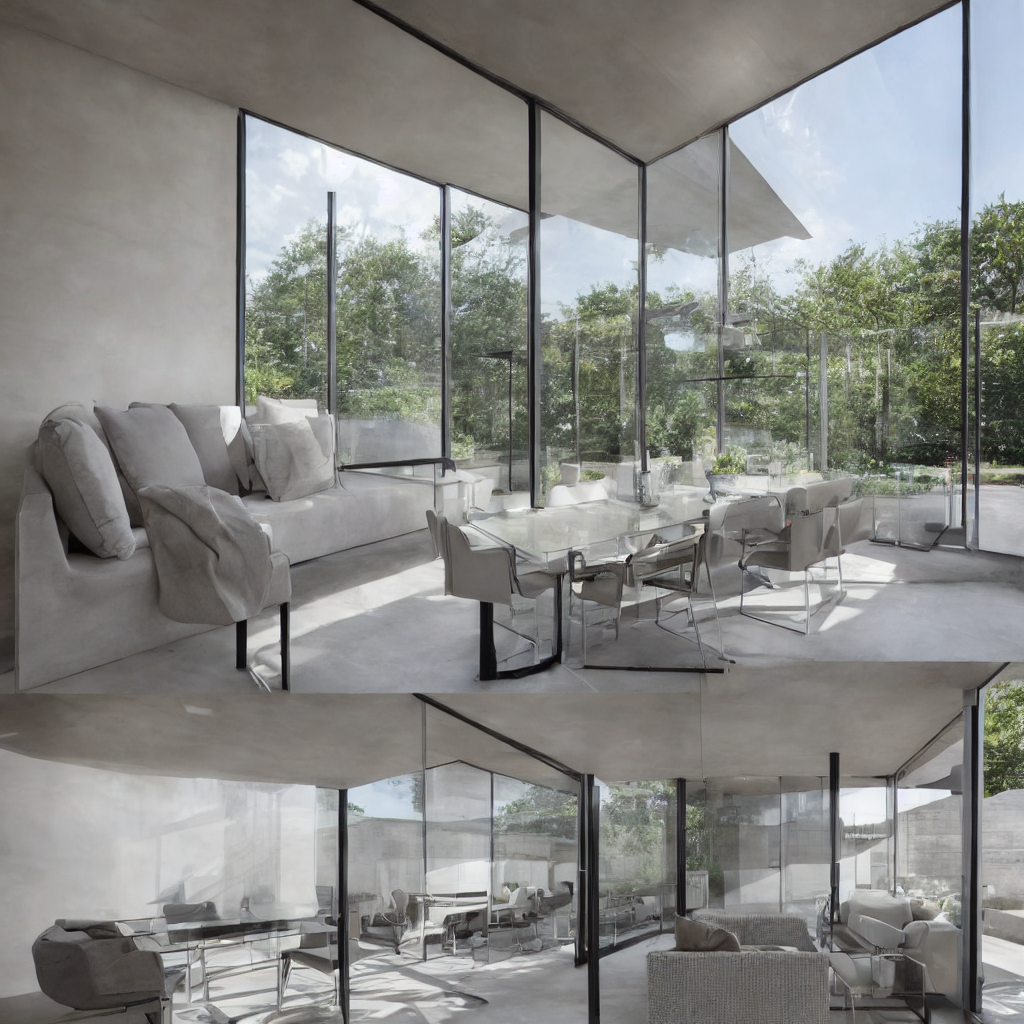
Wynik jest całkiem ciekawy. Ale nie jestem do końca pewien, na co patrzę. Czy to jeden obraz, czy dwa połączone ze sobą? Szczerze mówiąc, mogę czekać nawet godzinę, żeby dostać coś użytecznego. W latach 2023 i 2024 próbowałem komercyjnych usług do generowania projektów graficznych i nie radziły sobie nawet z prostymi zadaniami. Zamiast więc płacić 20 USD czy coś koło tego, wolę kupić GPU i zużyć trochę domowego prądu, żeby generować bardzo podobne obrazy. To po prostu moja preferencja.
Podsumowanie #
Nie zamierzam płacić OpenAI. Te narzędzia dają mnóstwo frajdy i zwiększają produktywność.