Exo: klaster GPU (tinygrad | MLX)
Przetłumaczone automatycznie z angielskiego. Przeczytaj oryginał
Teoria: uruchamianie obciążeń AI rozłożonych na różne urządzenia z użyciem pipeline parallel inference
W teorii Exo pozwala uruchamiać wymagające dużo pamięci modele AI/LLM na wielu różnych urządzeniach, rozkładając pamięć i obliczenia między nie.
Twórcy mówią: „Połącz swoje istniejące urządzenia w jedno potężne GPU: iPhone, iPad, Android, Mac, NVIDIA, Raspberry Pi, praktycznie dowolne urządzenie!”
Ludzie mówią: „Wymaga mlx, a to, o ile wiem, biblioteka tylko dla Apple silicon. Jak to ma działać (cytuję) „iPhone, iPad, Android, Mac, Linux, praktycznie dowolne urządzenie”? Czy było to testowane na czymkolwiek innym niż MacBook autora?”
Sprawdźmy to więc!
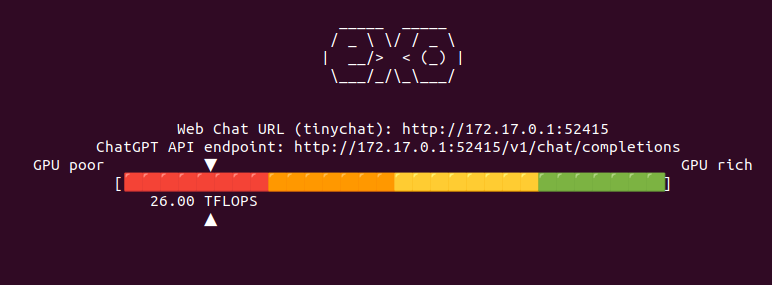
Mój zestaw to RTX 3060 z 12 GB VRAM. Działa na Linuksie/NVIDIA z domyślnym runtime tinygrad. Na Macu będzie to runtime MLX. Komunikacja odbywa się przez zwykłą sieć. Wykorzystywany jest CUDA toolkit oraz biblioteka cuDNN (deep neural network).
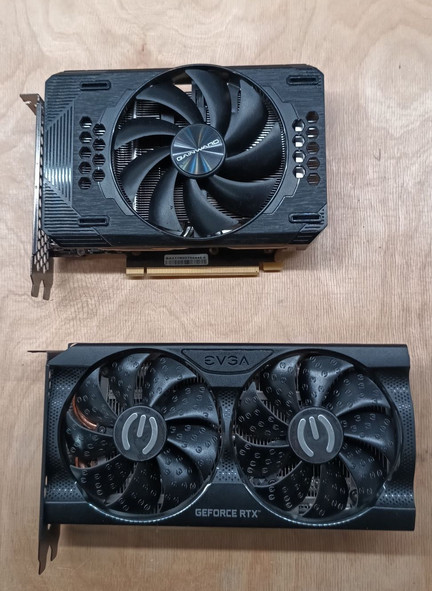
Szybkie porównanie Exo i Ollama z Llama 3.2:1b #
Fakt: serwer Ollama ładuje i wykonuje modele szybciej niż Exo
Uruchomienie Llama 3.2 1B na pojedynczym węźle wymaga 5,5 GB VRAM. Nie, nie da się użyć wielu GPU w jednym węźle. Próbowałem na różne sposoby, ale to nie działa; istnieje w tej sprawie feature request. T. Powinieneś otrzymać URL czatu, na który możesz wejść przez zwykłą przeglądarkę. Aby mieć pewność, że Exo wybierze właściwy interfejs sieciowy, po prostu przekaż adres przez parametr –node-host. Aby uruchomić Exo, wykonaj następujące polecenie:
exo --node-host IP_A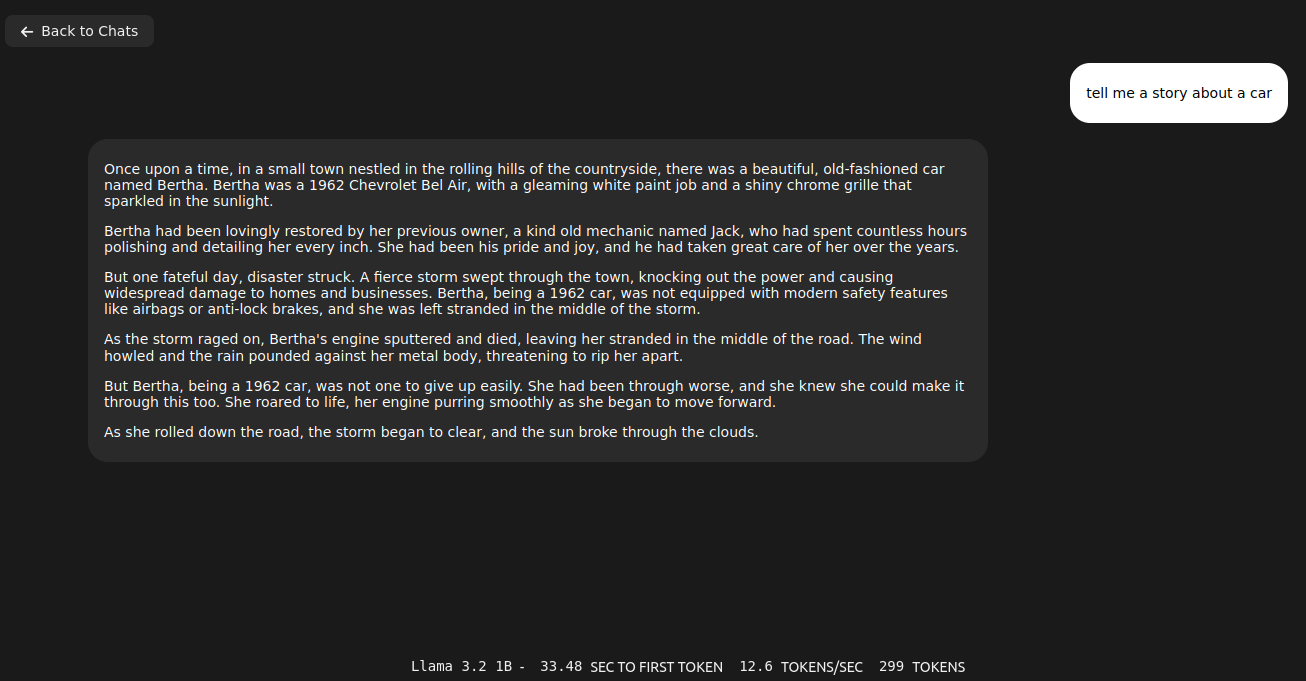
Natomiast to samo uruchomione na serwerze Ollama zajmuje tylko 2,1 GB VRAM (wobec 5,5 GB VRAM w Exo) i może nawet działać na CPU/RAM. Szybkość generowania tokenów przez serwer Ollama jest znacznie wyższa niż w Exo.
sudo docker run -d --gpus=all -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama
sudo docker exec -it ollama ollama run llama3.2:1b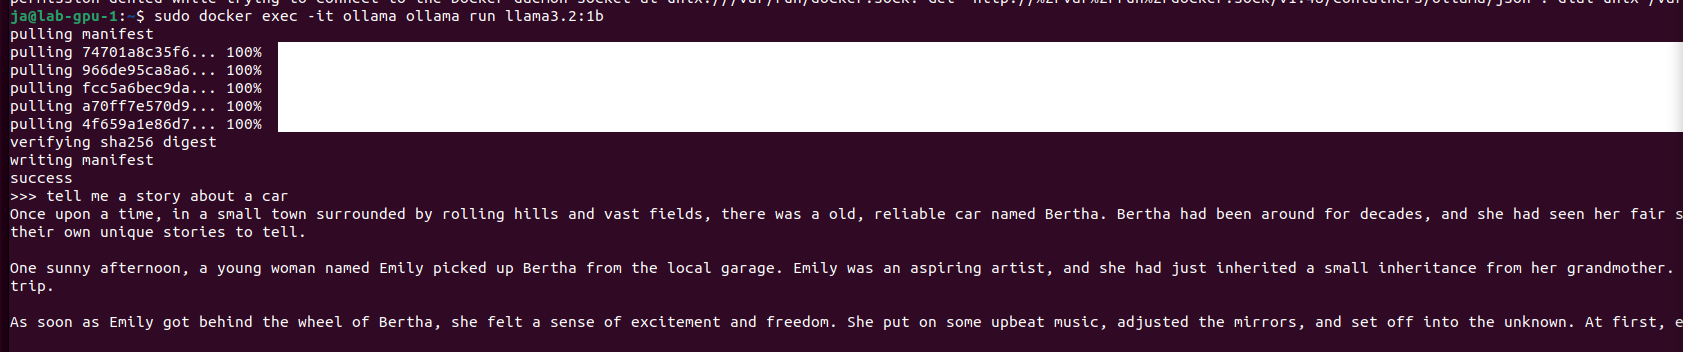
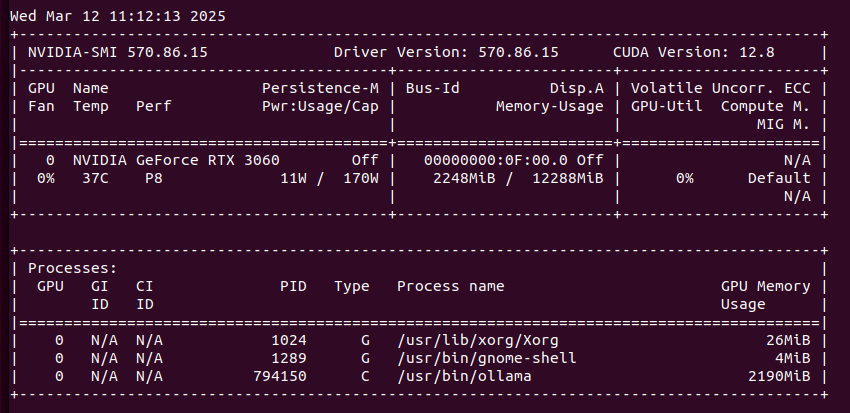
W tym pobieżnym (wąskim) porównaniu serwer Ollama wygrywa więc zarówno pod względem zużycia pamięci, jak i szybkości generowania. Na tym etapie oba dają w miarę użyteczne odpowiedzi/treści. Dociśnijmy je bardziej, próbując 3.2:3b. Najpierw z Exo:
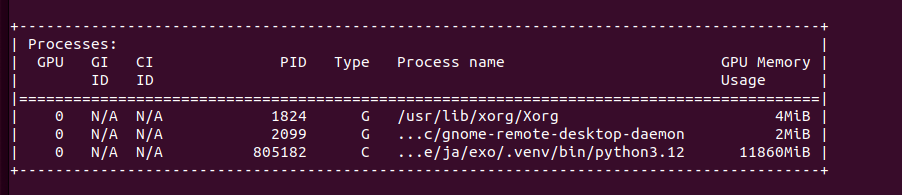
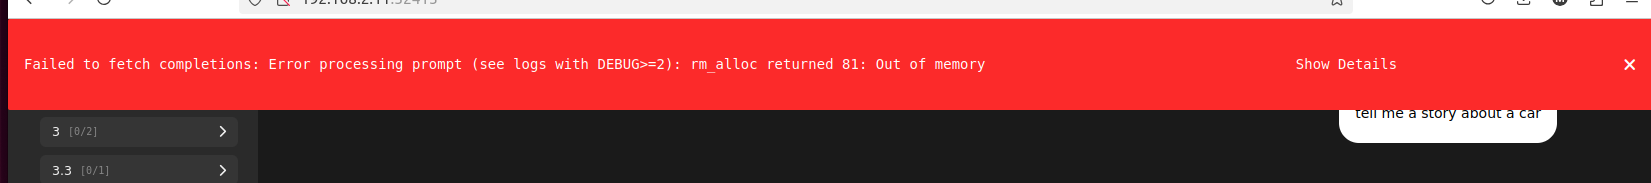
Bez powodzenia. Próbował zaalokować więcej niż 12 GB VRAM na pojedynczym węźle. Dla porównania spróbujmy z serwerem Ollama:
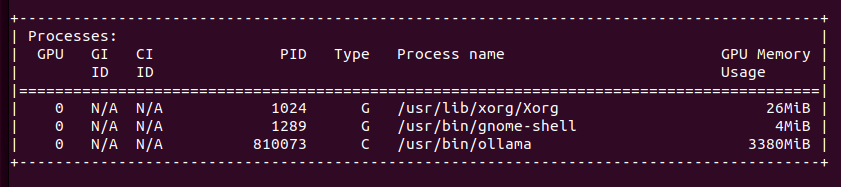
Dał mi dość długą historię. Zmieścił się w pamięci, zużywając tylko 3,3 GB VRAM. Llama 3.1:8b zajmuje 6,1 GB VRAM. Potrafi generować kod źródłowy OpenSCAD dla projektów 3D, więc jest całkiem przydatna. Z Ollamą udało mi się nawet uruchomić QwQ z 20B parametrów, zajmujący 11 GB VRAM i 10 GB RAM przy wykorzystaniu 1000% CPU, co w przybliżeniu przekłada się na 10 vCPU na 100%. On również potrafi dostarczyć kod OpenSCAD, jednak znacznie wolniej niż mniejsze modele, takie jak Llamy 3b czy 8b – kilka sekund wobec kilku minut generowania.
Dodanie drugiego węzła do klastra Exo #
Fakt: wyniki nadal absurdalne
Dodajmy teraz drugi węzeł do klastra Exo, żeby sprawdzić, czy poprawnie obsłuży dwa węzły, każdy z RTX 3060 12 GB, co daje łącznie 24 GB VRAM. Twierdzi, że łącznie mam 52 TFLOPS. Jednak z analizy kodu źródłowego Exo wiem, że jest to zahardkodowane:

To samo dotyczy modeli dostępnych przez TinyChat (interfejs webowy Exo):
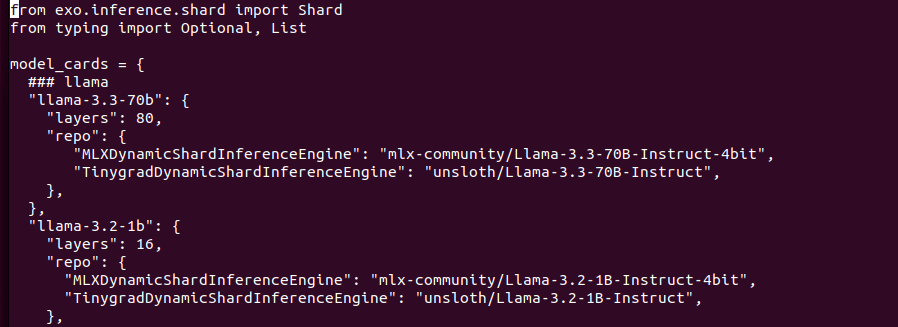
Struktura modeli zawiera osobno wersje dla Tinygrad i MLX, ponieważ mają one różne formaty. Modele są pobierane z HuggingFace. Próbowałem podmienić URL-e modeli, żeby uruchomić inne, bez powodzenia. Mógłbym znaleźć podobne modele od unsloth z tą samą liczbą warstw itd., ale porzuciłem ten pomysł, bo szczerze mówiąc nie jest to aż tak ważne. Spróbujmy z „wbudowanymi” modelami.
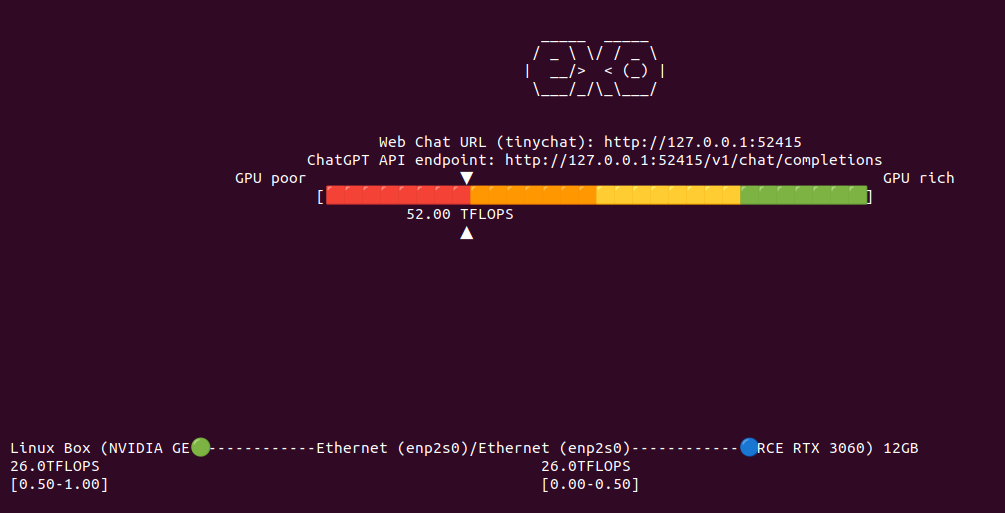
Mam więc teraz 52 TFLOPS podzielone na dwa węzły komunikujące się przez sieć. Zrestartowałem oba procesy Exo, żeby wyczyścić VRAM z poprzednich testów i mieć pewność, że zaczynamy od zera. Poprosiłem Llamę 3.2:1B o wygenerowanie kodu OpenSCAD. Do pierwszego tokena minęło 26 sekund, 9 tokenów/s, wynik całkowicie absurdalny, a łącznie na dwóch węzłach zajęte jest ok. 9 GB VRAM (4 GB i 5 GB).
Większe modele #
Fakt: Exo jest pełne dziwnych błędów i nieudokumentowanych funkcji
Więc… daleko od ideału, ale działa. Spróbujmy z większym modelem, który w Exo nie mieści się w klastrze z jednym węzłem.
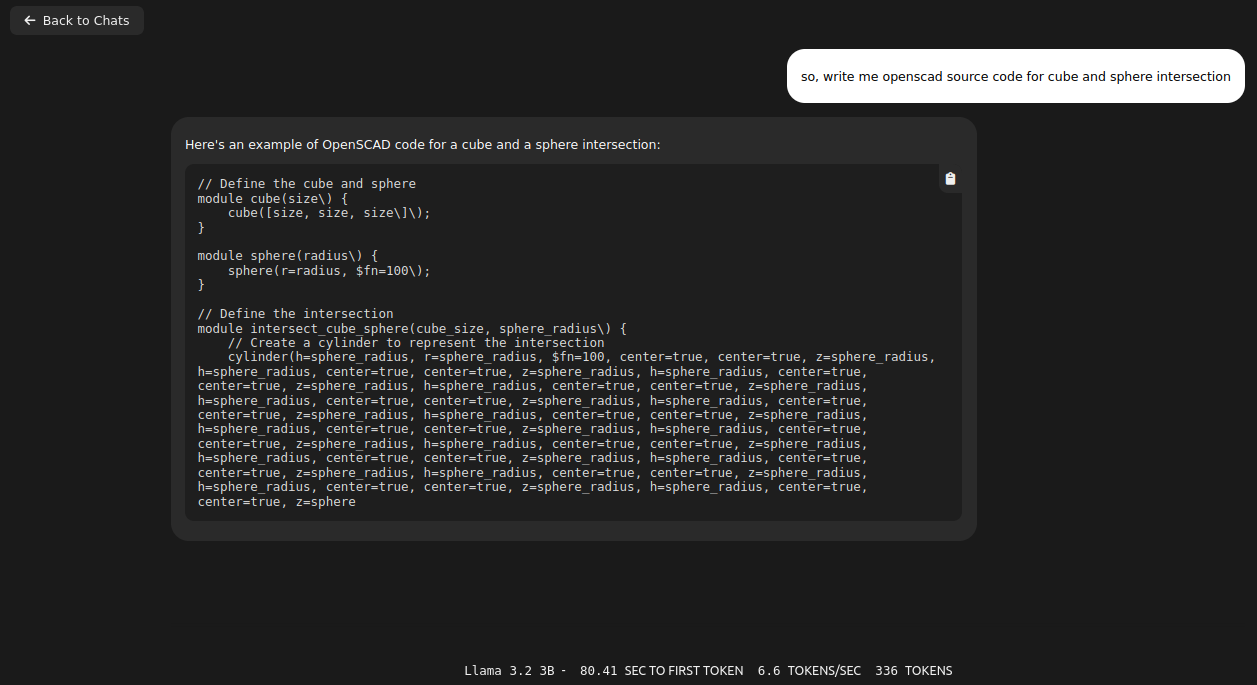
Załadowałem Llamę 3.2:3B i zajęła ponad 8 GB VRAM na każdym węźle, czyli łącznie 16 GB VRAM. To samo pytanie o kod OpenSCAD dało lepsze wyniki (choć nadal niepoprawne…), jednak wciąż z nieskończoną pętlą na końcu.
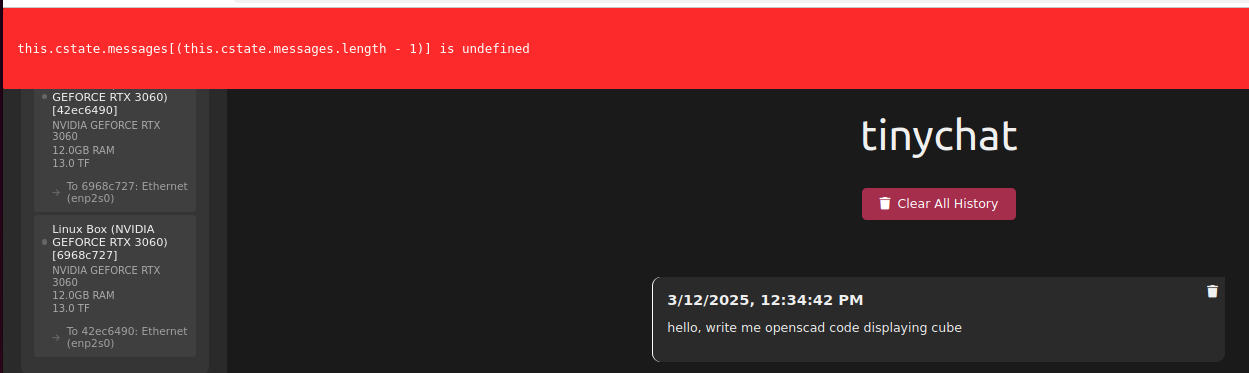
Pomyślałem, że przełączenie się na tag v1.0 będzie dobrym pomysłem. Myliłem się:
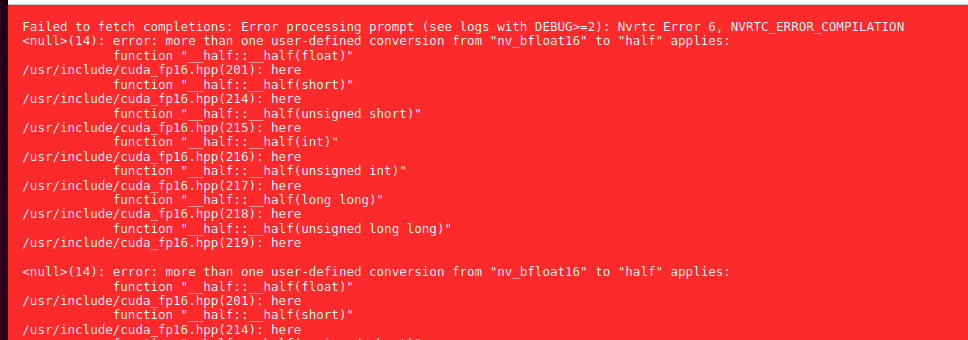
Są też problemy z pobieraniem modeli. Przechowywane są w katalogu ~/.cache/exo/downloads, ale z jakiegoś powodu nie są poprawnie rozpoznawane, co prowadzi do pobierania ich w kółko od nowa.
Ubuntu 24 #
Fakt: błędy nie wynikają z Ubuntu 22 czy 24
W poprzednich sekcjach tego artykułu używałem Ubuntu 22 z NVIDIA 3060 12 GB. Zawiera ono Pythona 3.10 oraz ręcznie zainstalowanego Pythona 3.12 z PIP 3.12. Natrafiłem na zgłoszenie na GitHubie, w którym znalazłem wskazówkę dotyczącą uruchamiania Exo w systemie z Pythonem 3.10:
https://github.com/exo-explore/exo/issues/521
Postanowiłem więc przeinstalować swoje serwery laboratoryjne z Ubuntu 22 na 24.
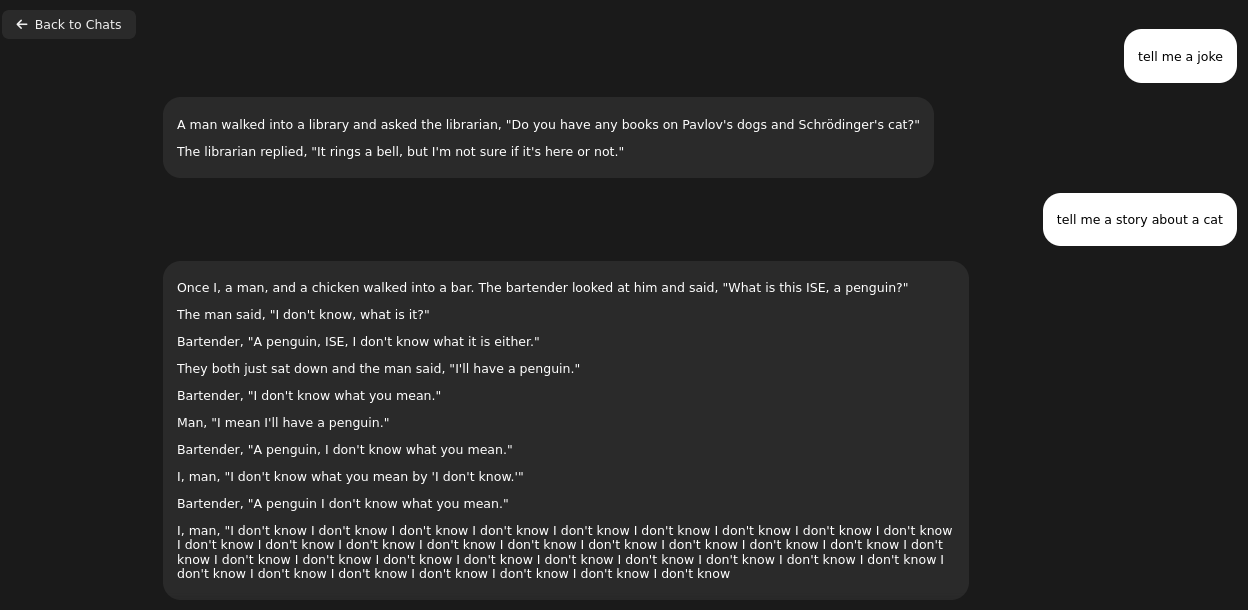
W efekcie mam tę samą pętlę na końcu. Na razie mogę więc stwierdzić, że to nie jest problem Ubuntu, lecz raczej wina Exo, Tinygrad lub jakiejś innej biblioteki.
Ręcznie wywołany prompt #
Fakt: miesza konteksty i nie zwalnia poprzednich warstw
Spróbowałem więc wywołać Exo zapytaniem cURL, zgodnie z sugestią w dokumentacji. Wygenerowanie odpowiedzi trwało dość długo. Była ona jednak całkiem dobra. Nie ma się specjalnie do czego przyczepić.
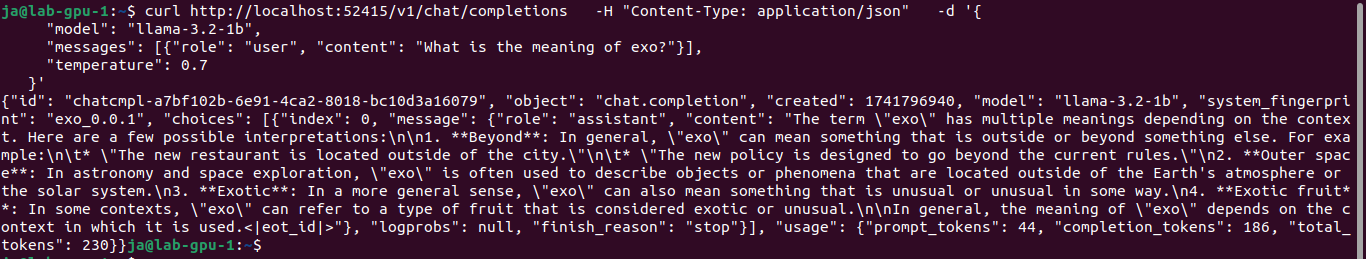
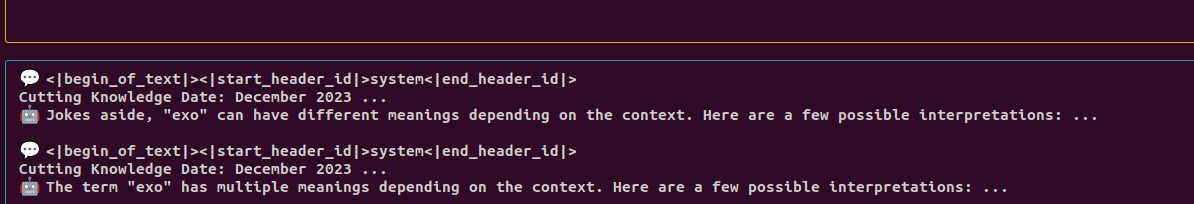
Zadałem kolejne pytanie bez restartu Exo, czyli przy warstwach obecnych w pamięci, i zaczął udzielać bełkotliwych odpowiedzi, mieszając konteksty.

Podaje dalsze wyjaśnienia do wcześniej zadanych pytań. Nie do końca to, czego się oczekiwało:
Można użyć examples/chatgpt_api.sh, który daje podobne wrażenia. Wyniki są jednak mieszane, w większości negatywne, z tą samą pętlą na końcu generowania. Nie jest to w żaden sposób ograniczone, więc będzie generował, generował, generował…
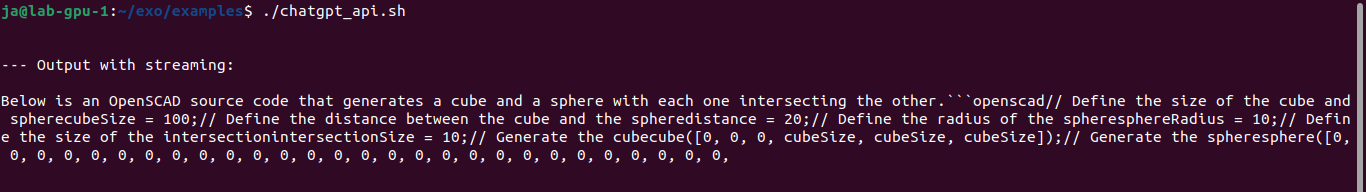
Są więc problemy z ładowaniem/zwalnianiem warstw, a także niekończąca się pętla podczas generowania.
W końcu dostałem taką odpowiedź:
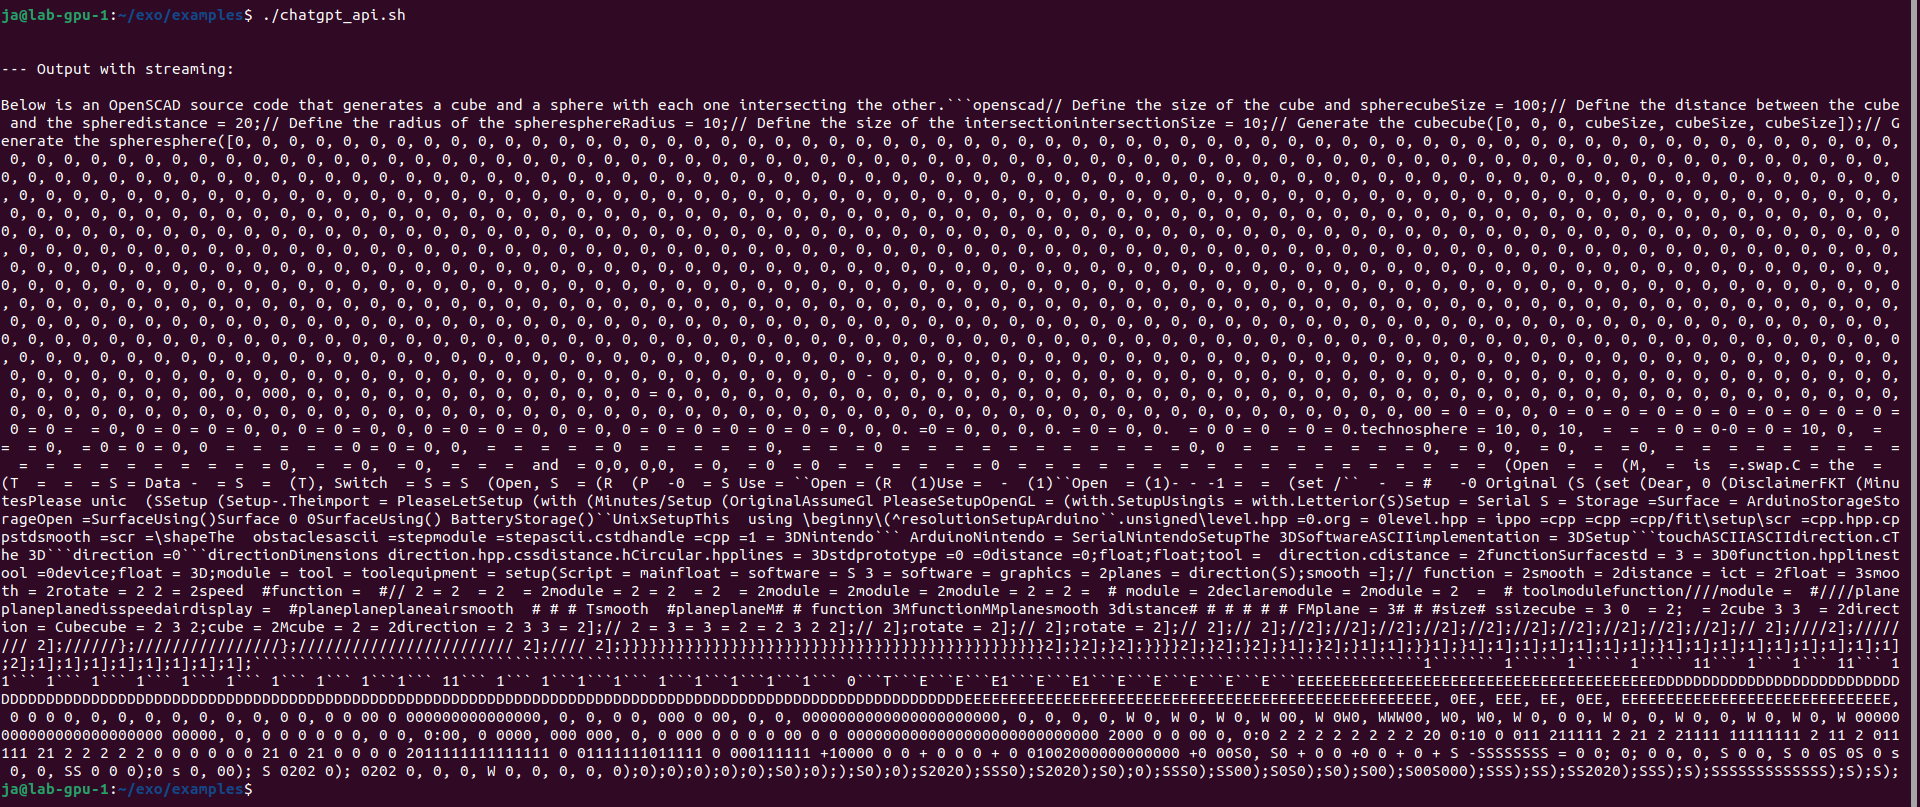
Zainstalowałem też Pythona 3.12 ze źródeł przy użyciu pyenv. Wymaga to obecności w systemie mnóstwa bibliotek, takich jak ssl, sqlite2, readline itd. Nic się nie zmienia. Nadal nie zwalnia warstw i miesza konteksty.
Inne problemy przy DEBUG=6 #


Uruchamianie na CPU #
Fakt: nie działa na CPU
Nie udało mi się również uruchomić obliczeń na CPU zamiast na GPU. Dokumentacja i issue tracker mówią, że trzeba ustawić parametr CLANG=1:
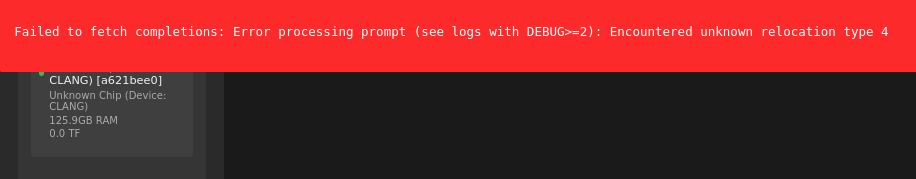
Ładuje się do RAM i działa na CPU w jednym procesie. Po 30 sekundach zwraca „Encountered unkown relocation type 4”.
Podsumowanie #
Albo potrzebuję innego sprzętu, systemu operacyjnego lub bibliotek, albo to całe Exo w ogóle nie działa… Spróbuję jeszcze raz później.