BLOOM LLM: jak go używać?
Przetłumaczone automatycznie z angielskiego. Przeczytaj oryginał
Zapytany „what is love?” BLOOM-560M odpowiada: „Kobieta, z którą przeżyłem pierwszy pocałunek w życiu, nie miała pojęcia, że jestem mężczyzną”. wtf?!
Wstęp #
Interesuję się obliczeniami równoległymi od 2021 roku, bawiąc się OpenCL (możesz o tym przeczytać tutaj) i szukając sposobów na maksymalne wykorzystanie możliwości urządzeń. Mam całkiem solidną, dogłębną wiedzę o tym, jak przebiega proces obliczeniowy na GPU, i jestem ciekaw, jak działają najnowsze technologie AI/ML/LLM. Oto więc moje krótkie wprowadzenie do tematu LLM z praktycznego punktu widzenia.
Plan działania #
- Przegląd BLOOM
- vLLM
- Transformers
- Maszyna wirtualna NV w Microsoft Azure
- Co dalej?
Czym jest BLOOM? #
To BigScience Large Open-science Open-access Multilingual language model, czyli wielojęzyczny model językowy. Opiera się na koncepcji głębokiego uczenia z użyciem transformerów, w której tekst jest zamieniany na tokeny, a następnie na wektory dla tablic wyszukiwania. Samo głębokie uczenie to metoda uczenia maszynowego oparta na sieciach neuronowych, w której trenuje się sztuczne neurony. BLOOM jest darmowy i został stworzony przez ponad 1000 badaczy. Został wytrenowany na około 1,6 TB wstępnie przetworzonego wielojęzycznego tekstu.
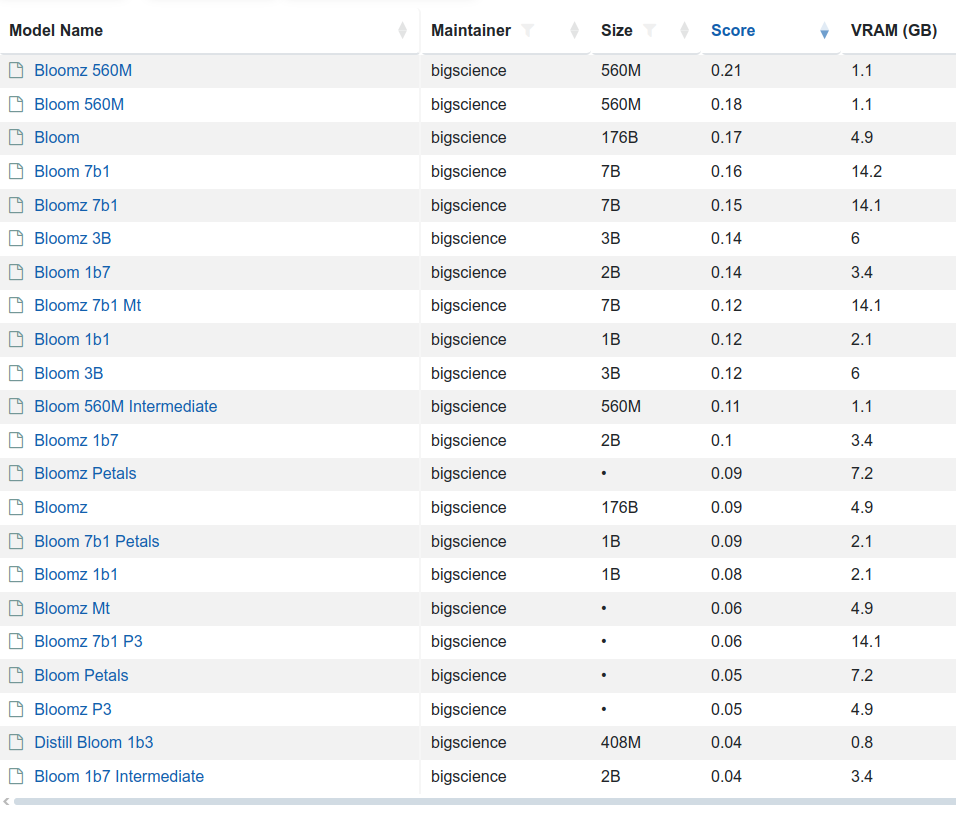
Istnieje kilka wariantów tego modelu: 176 miliardów parametrów (nazywany po prostu BLOOM), ale także BLOOM 1b7 z 1,7 miliarda parametrów. Jest nawet BLOOM 560M:
- do załadowania i uruchomienia 176B potrzeba 350 GB VRAM przy FP32 i połowę tego przy FP16
- do załadowania i uruchomienia 1B7 potrzeba gdzieś między 10 a 12 GB VRAM i połowę tego przy FP16
Aby więc użyć mojej karty NVIDIA GeForce RTX 3050 Ti z 4 GB pamięci, musiałbym albo uruchomić BLOOM 560M, który wymaga od 2 do 3 GB VRAM, a nawet poniżej 2 GB VRAM w przypadku mieszanej precyzji FP16, albo… użyć CPU. 176B wymaga 700 GB RAM, 1B7 wymaga 12–16 GB RAM, a 560M wymaga 8–10 GB RAM.
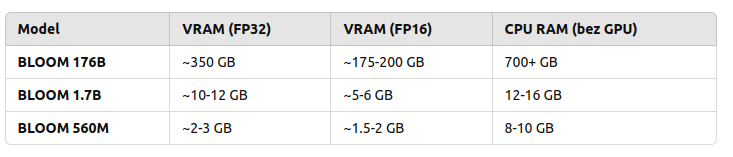
Czy to wiarygodne liczby? Sprawdźmy!
vLLM #
„vLLM to biblioteka Pythona, która zawiera także prekompilowane binaria C++ i CUDA (12.1).”
„Wysokowydajny i oszczędny pamięciowo silnik inferencji i serwowania dla LLM-ów”
Modele językowe możesz pobrać (z Hugging Face – firmy założonej w 2016 roku w USA) i serwować w tych kilku krokach:
pip install vllm
vllm serve "bigscience/bloom"
A potem, gdy już wystartuje (i szczerze mówiąc, nie wystartuje tak po prostu…):
curl -X POST "http://localhost:8000/v1/chat/completions" \
	-H "Content-Type: application/json" \
	--data '{
		"model": "bigscience/bloom"
		"messages": [
			{"role": "user", "content": "Hello!"}
		]
	}'
Środowisko uruchomieniowe vLLM może korzystać z GPU lub CPU, ale także z ROCm, OpenVINO, Neuron, TPU i XPU. Wymaga GPU o compute capability 7.0 lub wyższej. Mój RTX 3050 Ti ma 8.6, ale moja Tesla K20Xm z 6 GB VRAM ma tylko 3.5, więc nie da się jej użyć.
Oto program w Pythonie:
from vllm import LLM, SamplingParams
model_name = "bigscience/bloom-560M"
llm = LLM(model=model_name, gpu_memory_utilization=0.6,  cpu_offload_gb=4, swap_space=2)
question = "What is love?"
sampling_params = SamplingParams(
    temperature=0.5,
    max_tokens=10,
)
output = llm.generate([question], sampling_params)
print(output[0].outputs[0].text)
W odpowiedzi dostajemy albo:
[rank0]: torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 736.00 MiB. GPU 0 has a total capacity of 3.81 GiB of which 73.00 MiB is free. Including non-PyTorch memory, this process has 3.73 GiB memory in use. Of the allocated memory 3.56 GiB is allocated by PyTorch, and 69.88 MiB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables)albo coś takiego:
No available memory for the cache blocks. Try increasing `gpu_memory_utilization` when initializing the engine.Być może później spróbuję sprawdzić to na większym GPU, ale na razie spróbuję uruchomić model za pomocą biblioteki transformers, co jest kolejnym tematem.
Transformers #
Wybrałem ten sam model BLOOM 560M. Najpierw trzeba zainstalować poniższe główne pakiety i mnóstwo zależności:
pip install transformers
pip install torch
pip install accelerate
Kod źródłowy programu w Pythonie korzystającego z tych bibliotek wygląda następująco:
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
tokenizer = AutoTokenizer.from_pretrained("bigscience/bloom-560m")
model = AutoModelForCausalLM.from_pretrained(
    "bigscience/bloom-560m",
    device_map="auto",
    torch_dtype="auto"
)
def ask_bloom(question, max_length=100, temperature=0.7):
    inputs = tokenizer(question, return_tensors="pt").to(model.device)
    output = model.generate(
        inputs['input_ids'],
        max_length=max_length,
        temperature=temperature,
        pad_token_id=tokenizer.eos_token_id,
        do_sample=True
    )
    answer = tokenizer.decode(output[0], skip_special_tokens=True)
    return answer
question = "What is love?"
answer = ask_bloom(question)
print(f"Q: {question}\nAnwser: {answer}")
Aby uruchomić:
python3 transformers-torch.py
Program pobierze model i wykona go w Pythonie.
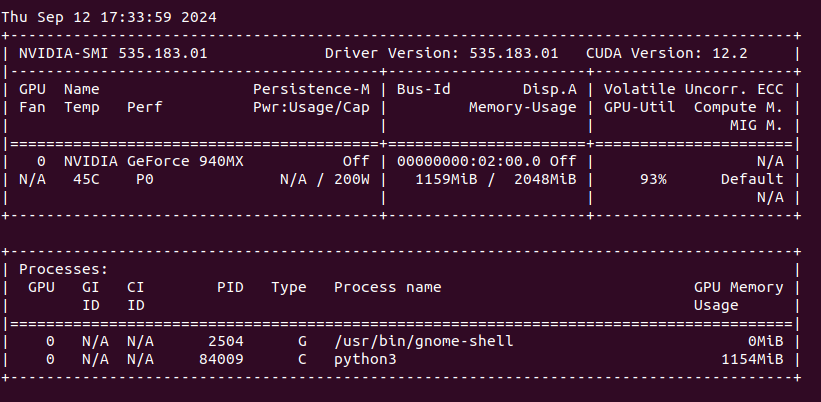
Widać, że pamięć mojej karty NVIDIA GeForce 940MX z 2 GB VRAM jest zajęta w około 60%, przy wykorzystaniu GPU powyżej 90% (wyniki z nvidia-smi).
„What is love?”. Odpowiedź wygląda następująco:
What is love? She never asked me the question but I am the one who has to give my answer. She is a beautiful, beautiful, very beautiful woman. The first thing you know about love is that it is the most complicated thing in the world. I was so shocked when I saw the man I thought I was marrying. My life was over. The woman who had my first kiss in my life had no idea that I was a man. She was so shocked. She said somethingNastępnie zapytałem o „The sun is shining and?”
I love this scene and I like when it comes to it. The sun, the sky and all the other stars are bright and I love that! I really enjoy this scene and it sets the scene for the rest of the story. It seems like the characters are just going about their day and the sun is shining. The world seems to be in its perfect place and everything is beautiful. I love the lighting in this scene and the warmth of the sunlight thatCzy to ma jakiś sens? Czym w ogóle jest pojęcie „sensu”? Tak czy inaczej, jakoś działa. Sprawdźmy inne możliwości.
Maszyny wirtualne serii N w Microsoft Azure #
Zamiast kupować MSI Vector, ASUS ROG, Lenovo Legion Pro, MSI Raider czy jakikolwiek inny topowy laptop gamingowy, idziesz do Azure i wybierasz ich maszyny wirtualne NV. Zwłaszcza że mają na pokładzie 14 i 28 GB VRAM. Kosztuje to około 400 euro miesięcznie, ale (jak przypuszczam) nie będziesz z tego korzystać cały czas.
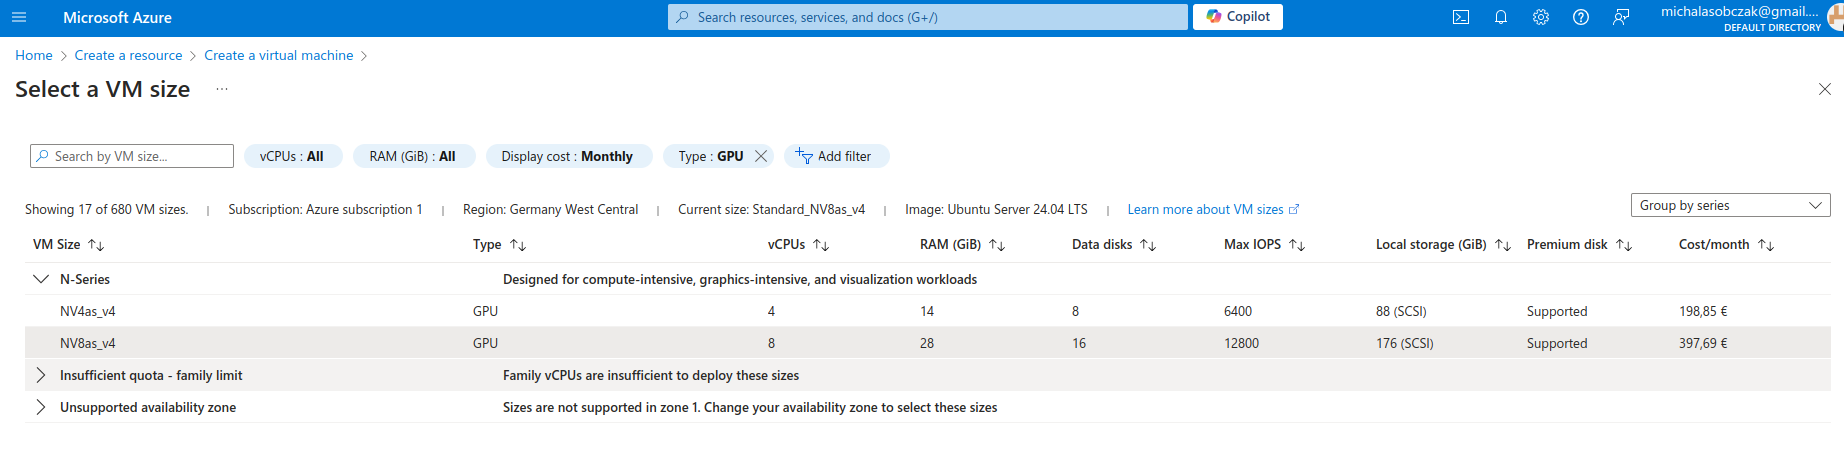
Mamy:
root@z92-az-bloom:/home/adminadmin# lspci
0002:00:00.0 VGA compatible controller: Advanced Micro Devices, Inc. [AMD/ATI] Vega 10 [Instinct MI25 MxGPU/MI25x2 MxGPU/V340 MxGPU/V340L MxGPU]
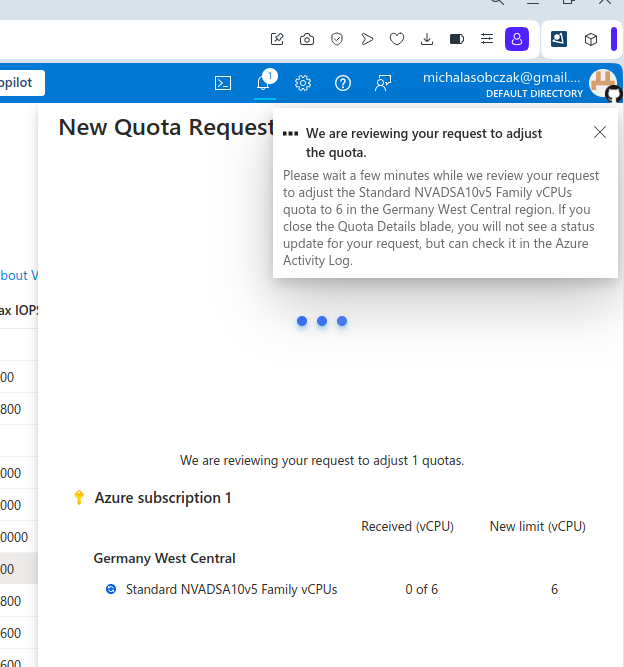
Nie byłem do końca pewien, jak używać GPU od AMD, więc zamiast tego postanowiłem złożyć wniosek o zwiększenie limitu:
Jednak ten wniosek na moim koncie został odrzucony:
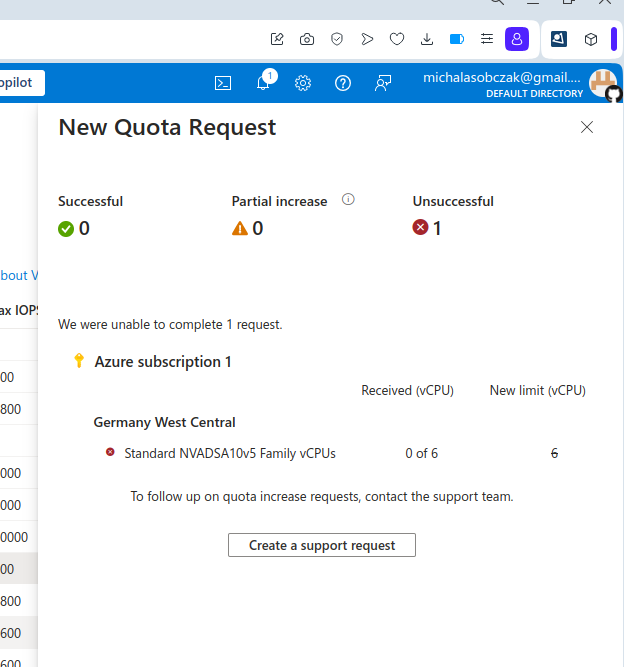
Niestety zmiana parametrów i typów maszyn wirtualnych nie zmieniła sytuacji – nadal dostawałem odmowę i musiałem złożyć zgłoszenie do supportu Microsoftu, aby rozpatrzono je ręcznie. Więc do następnego razu!
Co sprawdzić w następnej kolejności? #
AWS g6 i Hetzner GEX44. Czytaj dalej!
Dalsza lektura #
- Bloom 1b7 od bigscience, https://huggingface.co/bigscience/bloom-1b7
- Lista modeli Bloom, https://llm.extractum.io/list/?mtr=bigscience
- Biblioteka Transformers, https://huggingface.co/docs/hub/transformers
- vLLM:
- Inne modele, https://www.forbes.com/sites/bernardmarr/2024/05/07/the-best-open-source-generative-ai-models-available-today/