Trenowanie LLM na Mac Studio z użyciem frameworka MLX
Przetłumaczone automatycznie z angielskiego. Przeczytaj oryginał
Przeprowadziłem ponad 500 sesji treningowych z użyciem Qwen2.5, Qwen3, Gemma i wielu innych publicznie dostępnych LLM, aby wstrzyknąć wiedzę domenową do adapterów niskiego rzędu (LORA) modelu. Zamiast jednak zasypywać Cię masą nieistotnych faktów, skupię się na najważniejszych rzeczach. Zacznę od tego, że używałem MLX zarówno na moim Mac Studio M2 Ultra, jak i na MacBooku Pro M1 Pro. Oba dobrze sprawdzają się w tym zadaniu pod względem szybkości BF16, a także pojemności i szybkości pamięci zunifikowanej (do 800 GB/s).
Szybkość pamięci jest najważniejszym czynnikiem przy porównywaniu sprzętu GPU w obrębie podobnych generacji procesu technologicznego. Dlatego M2/M3 Ultra z wyższą szybkością pamięci wygrywa z M4 o niższej ogólnej przepustowości pamięci.
LORA i MLX #
Czym jest LORA? W tym typie treningu bierze się tylko fragment dużego modelu i trenuje jedynie niewielką część parametrów, np. 0,5 lub 1%, co w większości modeli daje od 100 tys. do 50 mln parametrów dostępnych do treningu. Czym jest MLX? To framework Apple do obliczeń na tablicach, który przyspiesza zadania uczenia maszynowego.
Jak MLX i LORA mają się do innych frameworków na innym sprzęcie? MLX stosuje nieco inną organizację wag i inny sposób osiągania tego samego, co robią inne frameworki, ale z przyspieszeniem Apple Silicon. Trening na nowoczesnych, wydajnych kartach NVIDIA RTX jest kosztowny zarówno w zakupie, jak i pod względem poboru mocy, a znacznie przystępniej jest robić to na Mac Studio z, powiedzmy, 64 GB RAM. Zwróć uwagę, że do zadań ML (ogólnie mówiąc rzeczy związanych z GPU) dostajesz ok. 75% pojemności RAM, więc na Mac Studio z 64 GB mam dostępne ok. 45–46 GB. A teraz poszukaj w sieci kart RTX z podobną ilością VRAM 😉
Konfiguracja #
Więc…
Oto przykładowa konfiguracja treningu z użyciem Qwen2.5, dość dużego modelu 14B, wstępnie wytrenowanego do zastosowań typu Instruct, przechowującego wagi w BF16, które działają do 50% szybciej niż podobne 16-bitowe floaty, a nawet wagi 8-bitowe. Mam „tylko” odpowiednio 64 GB i 32 GB pamięci, więc używam mniejszego batch_size i większego gradient_accumulation, co efektywnie daje mi batch size 4 x 8.
data: "data"
adapter_path: "adapters"

train: true
fine_tune_type: lora
optimizer: adamw
seed: 0
val_batches: 50
max_seq_length: 1024
grad_checkpoint: true
steps_per_report: 10
steps_per_eval: 50
save_every: 50

model: "mlx-community/Qwen2.5-14B-Instruct-bf16"
num_layers: 24
batch_size: 4
gradient_accumulation: 8
weight_decay: 0.001
grad_clip: 1.0
iters: 1000
learning_rate: 3.6e-5
lora_parameters:
  keys: ["self_attn.q_proj", "self_attn.k_proj", "self_attn.v_proj", "self_attn.o_proj", "mlp.down_proj","mlp.up_proj","mlp.gate_proj"]
  rank: 24
  scale: 6
  dropout: 0.1
lr_schedule:
  name: cosine_decay
  warmup: 200
  warmup_init: 1e-6
  arguments: [3.6e-5, 1000, 1e-6]
early_stopping_patience: 4
Najważniejsze parametry z punktu widzenia treningu to:
- liczba warstw, która przekłada się na liczbę parametrów dostępnych do treningu
- weight_decay w kontekście generalizacji
- grad_clip, gdzie definiujemy, jak mały/duży jest otwór, przez który przeciągamy gradienty, aby nie pozwolić im eksplodować, czyli nagle rosnąć coraz bardziej
- learning_rate, czyli jak szybko każemy modelowi uczyć się na naszych danych
- lora_parameters/keys – albo ograniczamy się tylko do self_attn.*, albo rozszerzamy trening także na mlp.*
- rank definiuje przestrzeń dla treningu
- scale, nazywany też alpha, to współczynnik wpływu
- dropout to współczynnik losowego usuwania/korekty
W różnych momentach/fazach treningu parametry te powinny przyjmować i będą przyjmować różne wartości w zależności od naszego przypadku użycia. Każdy parametr jest w jakiś sposób powiązany z pozostałymi. Na przykład learning rate koreluje pośrednio z WD, GC, rank, scale i d/o. Jeśli zmienisz liczbę warstw lub rank, musisz dostosować również pozostałe parametry. Kluczowe czynniki przy zmianie parametrów:
- liczba par QA w zbiorach danych
- liczba danych treningowych w stosunku do danych walidacyjnych
- struktura i jakość danych
- rozmiar modelu (liczba parametrów)
- liczba iteracji/epok (ile razy model widzi Twoje dane podczas treningu)
- czy chcesz uogólniać, czy specjalizować interakcję między danymi a modelem
Trening #
Trening można uruchomić w następujący sposób, łącznie z raportowaniem do W&B w celu lepszej analizy.
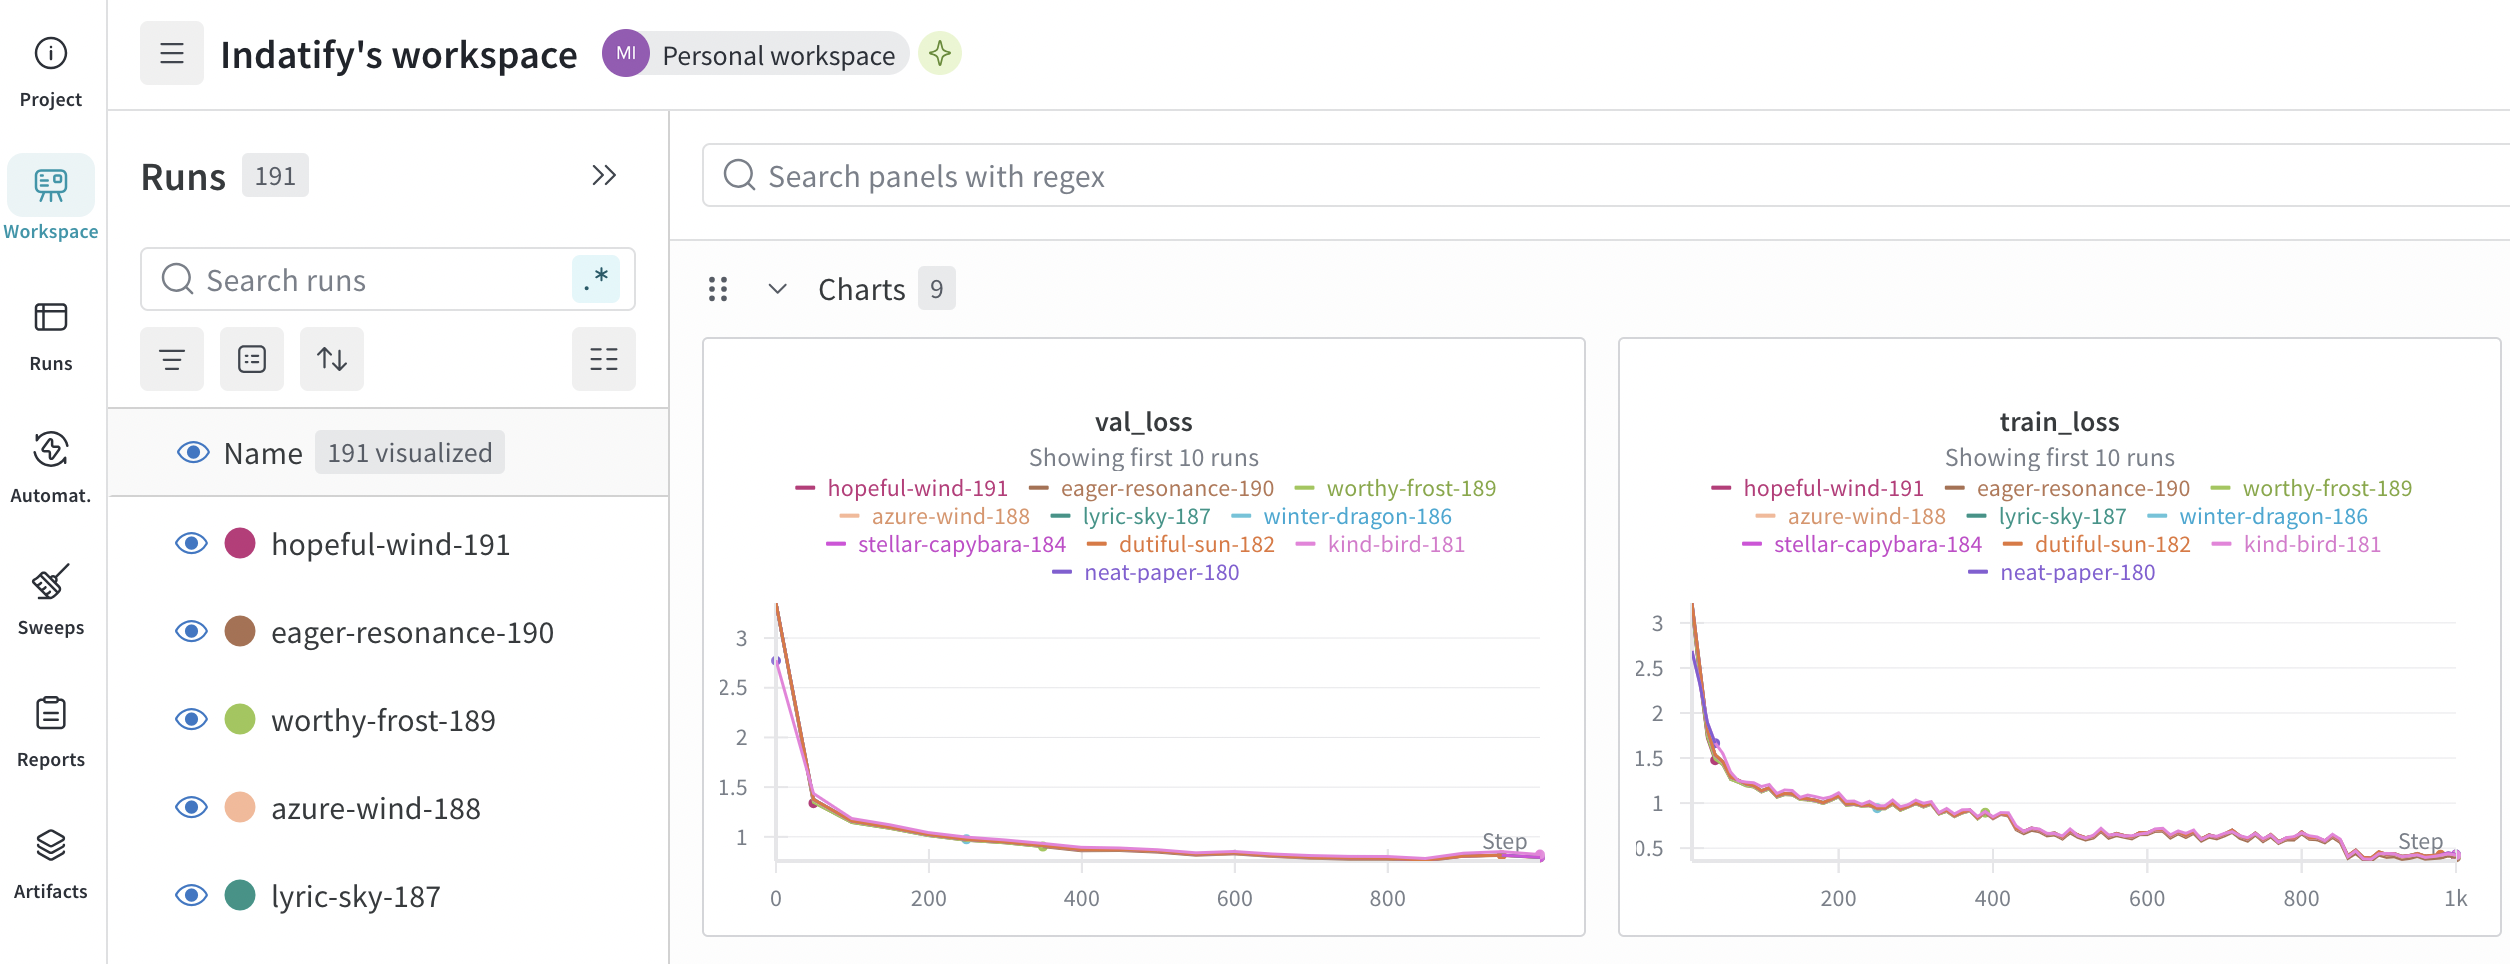
python -m mlx_lm lora -c train-config.yaml --wandb your-projectTrening możesz monitorować w konsoli albo w W&B. Ogólna zasada jest taka, że validation loss powinien spadać i powinien spadać razem z training loss. Training loss nie powinien być dużo niższy niż validation loss, bo może to oznaczać przeuczenie (overfitting), które pogarsza zdolność modelu do uogólniania. Idealna konfiguracja to zejście jak najniżej z obiema wartościami – zarówno validation, jak i training loss.
Iter 850: Val loss 0.757, Val took 99.444s
Iter 850: Train loss 0.564, Learning Rate 1.065e-05, It/sec 0.255, Tokens/sec 177.088, Trained Tokens 581033, Peak mem 33.410 GB
Iter 850: Saved adapter weights to adapters-drs2/adapters.safetensors and adapters-drs2/0000850_adapters.safetensors.
...
Iter 900: Val loss 0.805, Val took 99.701s
Iter 900: Train loss 0.422, Learning Rate 8.303e-06, It/sec 0.248, Tokens/sec 173.218, Trained Tokens 615120, Peak mem 33.410 GB
Iter 900: Saved adapter weights to adapters-drs2/adapters.safetensors and adapters-drs2/0000900_adapters.safetensors.
...
Iter 1000: Val loss 0.791, Val took 99.140s
Iter 1000: Train loss 0.396, Learning Rate 4.407e-06, It/sec 0.248, Tokens/sec 172.078, Trained Tokens 683991, Peak mem 33.410 GB
Iter 1000: Saved adapter weights to adapters-drs2/adapters.safetensors and adapters-drs2/0001000_adapters.safetensors.
Saved final weights to adapters-drs2/adapters.safetensors.
Łączenie LORA i eksport do GGUF #
Gdy skończysz trening, możesz albo używać adaptera LORA podczas generowania, albo po prostu połączyć ten adapter LORA z modelem bazowym, co jest wygodniejsze, ponieważ taki model można też skopiować do katalogu modeli LMStudio, co znacznie ułatwia korzystanie z nowo wytrenowanego modelu i jego ewaluację.
python -m mlx_lm.fuse --model $1 --adapter-path adapters --save-path model/$2
cp -r model/$2 /Users/your-user/.lmstudio/models/your-space/
Gdzie $1 to ścieżka modelu bazowego w HuggingFace, a $2 to nazwa modelu w ścieżce wyjściowej. Możesz też połączyć do formatu GGUF, używając --export-gguf, a także przekonwertować model HF do GGUF za pomocą llama.cpp (https://github.com/ggml-org/llama.cpp.git). Pamiętaj, że konwersja do GGUF lub do „formatu” Ollama może powodować problemy z jakością. Przyczyną może być formatowanie wag, reprezentacja liczb lub inne różnice w grafie, których na razie nie zidentyfikowałem.
python convert_hf_to_gguf.py ~/.lmstudio/models/your-space/your-model-folder --outtype q8_0 --outfile ./out.ggufDane #
Do rozpoczęcia treningu potrzebujesz danych. To zupełnie osobne zagadnienie, niezależne od właściwej parametryzacji procesu treningu. Chodzi nie tylko o same dane, ale o cały proces augmentacji obejmujący parafrazy, synonimy, przykłady negatywne, rozumowanie krok po kroku itd.
Dostępne formaty są następujące:
{"messages": [{"role": "user", "content": "What is AI?"}, {"role": "assistant", "content": "AI is..."}]}
{"prompt": "Explain quantum computing", "completion": "Quantum computing uses..."}
{"text": "Complete text for language modeling"}
Wypróbowałem wszystkie, a najbardziej atrakcyjny wydaje się format prompt/completion.