Pula ZFS w stanie DEGRADED, awaria dysku twardego
Przetłumaczone automatycznie z angielskiego. Przeczytaj oryginał
Mam używaną stację roboczą HP z800. W chwili zakupu był w niej dysk HDD – Western Digital WD5000AAKX-75U6AA0, SATA III, 500 GB, 7200 RPM, 16 MB cache. Niestety przechodzi test SMART i nie pokazuje wskaźnika zużycia. Jednak po wejściu w szczegółowe informacje widzimy:
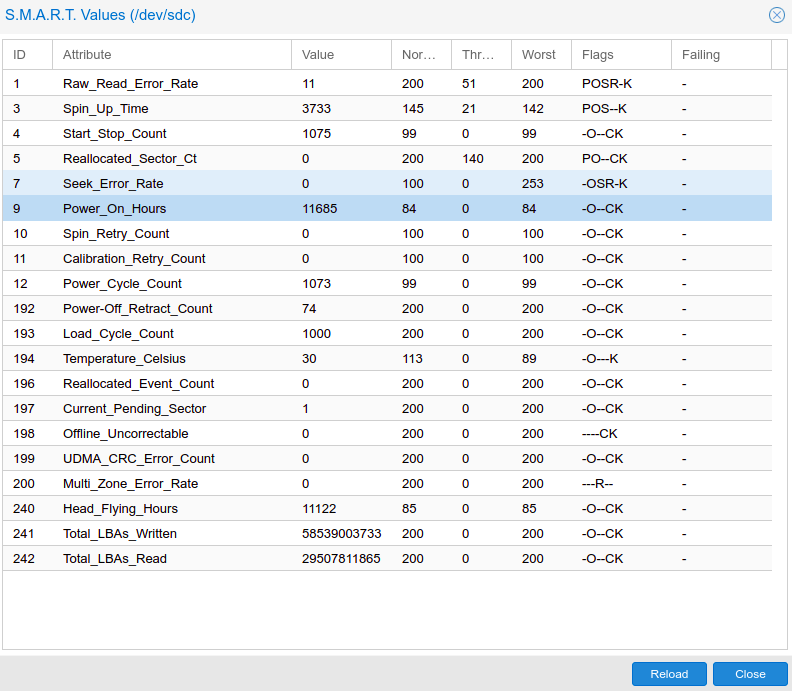
Raw_Read_Error_Rate ma dodatnią wartość 11, a próg ustawiony jest na 51. Przy 11 685 godzinach pracy można zrozumieć, że dysk mógł się zepsuć – i faktycznie się zepsuł. Jest tylko jeden Current_Pending_Sector, co oznacza, że czeka on na przemapowanie lub realokację. Ale czy nastąpi to w najbliższym czasie?
Nie jestem w stanie sklonować, zmigrować ani zreplikować VM na inny serwer. ZFS informuje, że ta pula jest w stanie degraded. Widać to za pomocą polecenia zfs status -v. Twierdzi, że błąd jest nienaprawialny, i najprawdopodobniej tak jest. Próbowałem zpool scrub river – bez skutku. Problem dotyczy dysku VM-104. Mimo to wspomniana VM jest dostępna przez konsolę i działa bez zarzutu.
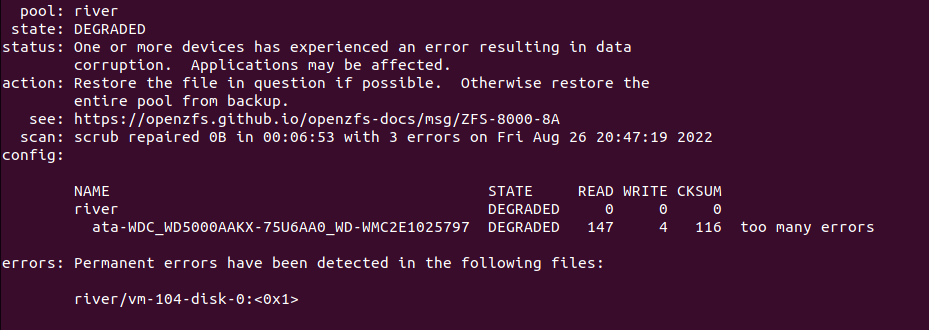
Ta VM to instalacja Redasha i jest to ostatnia VM pozostała na tym dysku, czekająca na lepsze czasy. Ponieważ to domowy lab, korzysta z wszelkich urządzeń, jakie mam pod ręką. Jak widać, nie wszystkie są w pełni sprawne. Zawsze trzeba mieć backupy, zreplikowane VM i RAID skonfigurowany z redundancją.
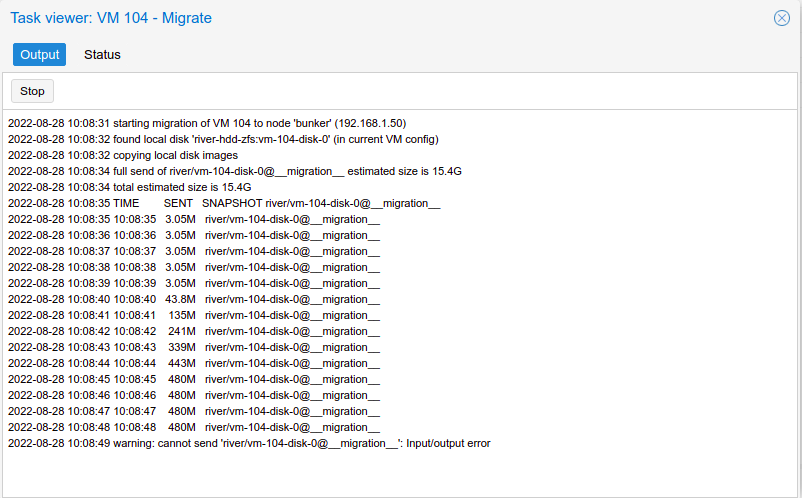
Nie udało mi się zmigrować VM:
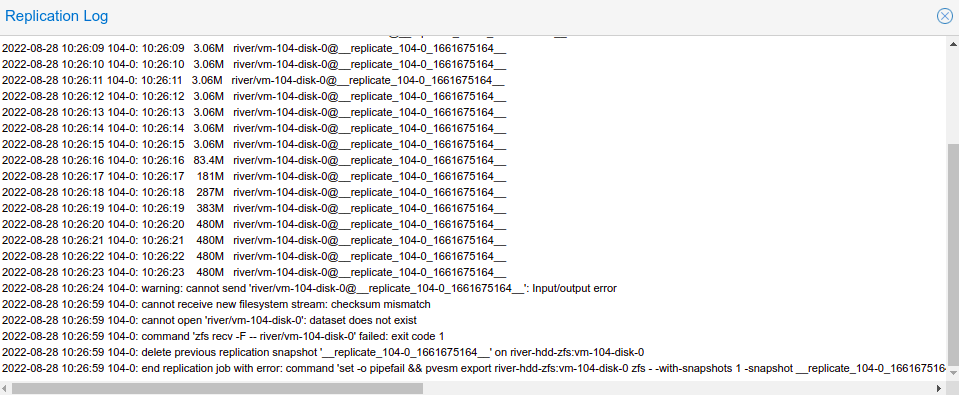
Nie udało mi się zreplikować VM:
Nie udało mi się zrobić backupu VM:
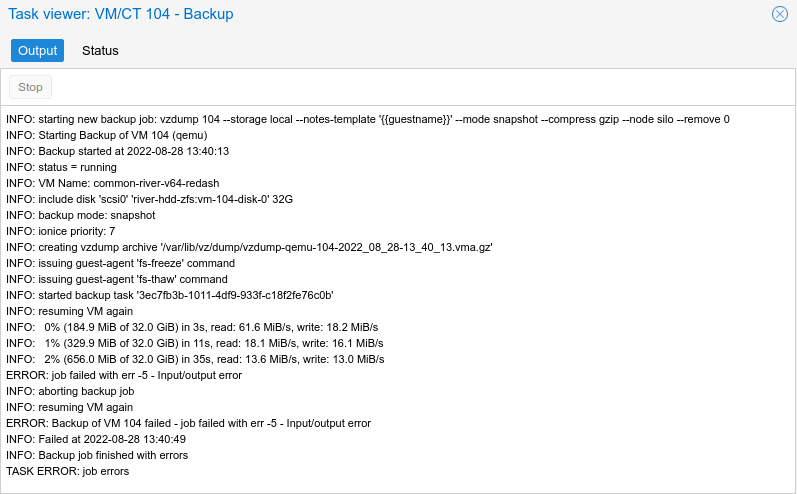
Ostatecznie zidentyfikowałem 4 lub więcej uszkodzonych bloków, ale ponieważ to ZFS, narzędzi do sprawdzania systemu plików jest niewiele. Czy pula ZFS powinna teoretycznie być w stanie odzyskać sprawność po takiej awarii? Jeśli używasz konfiguracji z dyskami w lustrze, to nie ma takiego problemu. Myślałem o nadpisaniu tych bloków, ale zostawiłem to tak, jak było. Dysk został wycofany z użytku.