Data mining i eksploracja danych
Przetłumaczone automatycznie z angielskiego. Przeczytaj oryginał

Spośród 3 milionów publicznych zakresów adresów IP na całym świecie 68 tys. należy do Federacji Rosyjskiej. Przekłada się to na 45 milionów adresów. Skanowanie portu HTTP w tej populacji zajęło 20 godzin. Uzyskałem 630 tys. adresów IP nasłuchujących na porcie 80. Z czego 530 tys. udziela poprawnej odpowiedzi typu HTTP. Tylko 340 tys. zwraca odpowiedź HTTP 200. Ponad 200 tys. działa na serwerach NGINX, a 100 tys. na Apache. Analizując treść, znajdziemy instalacje GitLab, Kibana, Zabbix czy Grafana otwarte na rejestrację i użytkowanie, ale także kopie baz danych, systemy monitoringu wizyjnego itp. Moim ulubionym znaleziskiem jest jednak panel sterowania ciepłowni…
Kiedy na początku 2021 roku kupiłem stację roboczą HP z800, chciałem z jednej strony podnieść swoje kompetencje w zakresie optymalizacji sprzętu i oprogramowania, a z drugiej opisać to w formie publikacji, aby dostatecznie ugruntować swoją wiedzę. W ciągu kolejnych miesięcy koncepcja diametralnie się zmieniła i potrzebowałem więcej informacji. Uznałem, że muszę poszerzyć wiedzę o budowie sprzętu. Zwieńczeniem tego było opracowanie koncepcji serii zeszytów zatytułowanej „Simple High Performance Computing”, czyli HPC w wydaniu dostępnym w zasadzie dla każdego i przy każdym budżecie.
Spis treści #
- Kilka słów o serii zeszytów
- Grupa docelowa
- Narzędzia
- Sprzęt
- Ładowanie adresów
- Skanowanie serwerów HTTP za pomocą zmap
- Weryfikacja jakościowa
- Analiza wyników
- Analiza konfiguracji
- Analiza treści
- Na koniec
- Kontakt
Kilka słów o serii zeszytów #
W serii zaplanowano 6 części, 2 zostały już ukończone i wydane
Pierwsza część serii to „Podstawy elektroniki i budowa komputera w symulatorze”, wydana w 2021 roku (dostępna do pobrania pod tym adresem). Druga część (numer 5 w serii) to „OpenCL, programowanie CPU i GPU”, wydana w maju 2022 roku (dostępna do pobrania pod tym adresem). Oprócz tych dwóch pozycji seria obejmuje także części poświęcone przeglądowi platform komputerowych od lat 80. do dziś, w tym MOS 6502, Intel SSE, AltiVec, OpenGL i ewentualnie ESP8266. Ostatnia część to „Data Mining & Exploration”, która jest tematem tego artykułu.
Grupa docelowa #
Wykorzystanie bazy ip2location do skanowania wybranego terytorium
Jako przykład do eksploracji danych biorę kilka usług, ale zacznę od podstawowych, HTTP i DNS . Grupę docelową identyfikuję za pomocą bazy ip2location. Jest to zbiór zakresów w publicznym internecie wraz z informacją o przynależności do danego terytorium. Dziś mamy 2 975 657 sztuk wszystkich zakresów internetowych IPv4. Załadowane do PostgreSQL 14 zajmują 405 MB. W bazie ip2location tabela ip2location_db11 przechowuje zakresy publicznych adresów IPv4. Jest to najszerszy darmowy zbiór zawierający dane z dokładnością do miejscowości oraz przybliżoną lokalizację . Jest tu także kod pocztowy. Oczywiście w przypadku większych miejscowości i miast takich kodów może być wiele.
Uwaga: baza ip2location jest dostępna również w wersji komercyjnej, w której otrzymujemy dodatkowe metadane, a geolokalizacja jest znacznie dokładniejsza. Baza zawiera zakresy dla 242 terytoriów. Co ciekawe, baza WDI Banku Światowego definiuje 265 terytoriów, a członków Organizacji Narodów Zjednoczonych jest 193. Obie bazy starają się trzymać litery prawa w kwestii uznawania poszczególnych państw. Zatem nawet jeśli terytorium jest zależne od innego państwa, ale jest powszechnie uznawane, będzie miało osobne dane, na przykład Mariany Północne. Nie znajdziemy jednak Republiki Arcachu ani Kosowa.
Narzędzia #
Do eksploracji używam zmap, dig oraz aplikacji napisanej w Ruby
Program zmap jest przeznaczony do wysokowydajnego skanowania przestrzeni sieciowych. Przyjmuje się, że na odpowiednio dobranym sprzęcie i łączu internetowym można w ciągu kilku godzin przeskanować całą przestrzeń IPv4 na wybranym porcie TCP. Oczywiście tego typu masowe skany mogą spowodować umieszczenie naszego adresu na listach nadużyć i jego de facto zablokowanie w wielu miejscach na świecie. Są dwie strategie, by tego uniknąć. Pierwsza to użycie osobnej przestrzeni do takiego skanowania, np. maszyny wirtualnej w chmurze publicznej (DigitalOcean, Rackspace, Microsoft Azure itp.). Na początku mojej przygody z tego typu skanami sam wybrałem tę opcję. Po poinformowaniu dostawcy o planowanym skanowaniu nie powinniśmy mieć żadnych problemów, warto jedynie wspomnieć, że są to prace badawcze. Druga strategia, z której obecnie korzystam, to skanowanie z mniejszą przepustowością ściśle określonych regionów świata. Wadą tego rozwiązania jest oczywiście niższa wydajność, wynikająca z konieczności operowania na blokach CIDR, które zazwyczaj nie sąsiadują ze sobą tak, by można je było scalić. Brak możliwości randomizacji skanowania jest poważną wadą.
Jeśli chodzi o dig , używam go do testowania odpowiedzi serwerów DNS, ale także jako narzędzia do odwrotnego mapowania adresów IP na nazwy domen dla całej populacji adresów. Analiza domen dla usług HTTP jest interesująca, ale ciekawsze jest mapowanie domen dla wszystkich adresów IP, choć wymaga to użycia większej liczby serwerów DNS, aby nie zostać zablokowanym na tych najpopularniejszych.
Całość, czyli zarówno zadania oparte na zmap, jak i na dig, spina aplikacja, którą nazwałem miner, wykonana w Ruby i Ruby on Rails , służąca do uporządkowanego wykonywania takich operacji krok po kroku. W zasadzie aplikacja używa tylko ActiveRecord , Rake i HTTParty, więc mówienie, że to aplikacja Rails, jest nieco na wyrost. Do bardziej wymagających operacji używam dedykowanych modułów i metod do połączeń HTTP, ponieważ HTTParty ma różne ograniczenia i błędy, które przy takiej skali łatwo wychodzą na powierzchnię. To samo dotyczy biblioteki Parallel, która jest oczywiście nieoceniona w kontekście pracy współbieżnej, zwalniając użytkownika z konieczności bezpośredniej pracy na wątkach i procesach, ale ma szereg nierozwiązanych błędów i wycieków pamięci.
Uwaga: jeśli znajdę trochę wolnego czasu, spróbuję powtórzyć długodystansowe próby ujawnienia problemów z pamięcią w tych bibliotekach, aby mieć dowody do zgłoszenia błędów ich twórcom .
Sprzęt #
Paradoksalnie masowe skanowanie nie wymaga zbyt mocnego sprzętu
Jak wspomniałem we wstępie, do tej pracy używam stacji roboczej HP z800, która przyjmuje maksymalnie 2 CPU, każdy z 12 wątkami, co daje łącznie 24 procesory logiczne na stację (Intel Xeon X5660). Do testu użyłem dwóch takich stacji roboczych, więc miałem łącznie 48 procesorów. Jeśli chodzi o pamięć operacyjną, maksimum dla takiego zestawu to 768 GB DDR3, choć mam zainstalowane tylko 180 GB. Skanowanie i czynności wokół niego nie są pamięciochłonne, wymagają dużej ilości CPU i stabilnej sieci na warstwie sprzętowej i oprogramowania sieciowego. Do skanowania użyłem swojego łącza 1 Gbps downlink i 600 Mbps uplink. Ruchem sieciowym zarządza instalacja pfSense 2.6 na dedykowanym sprzęcie z procesorem Intel Xeon E3 1230. W szczytowym momencie skanowania liczba stanów na firewallu sięgnęła 500 000, co wynikało z liberalnej konfiguracji. Przy nieco bardziej rygorystycznej kontroli stanów ich liczba może być znacząco mniejsza, ale wtedy zwiększamy ryzyko zamknięcia dobrych stanów.
Uwaga: skanowanie można zasadniczo przeprowadzić na dowolnym sprzęcie z przyzwoitą kartą sieciową. Co oznacza przyzwoitą? Przede wszystkim powinna to być karta co najmniej 1 Gbps, a najlepiej o prędkości 10 Gbps. Powinna pochodzić od renomowanego producenta. Powinien to być też popularny model z dostępnym aktualnym firmware.
Ładowanie adresów #
Zamiana zakresów na właściwe publiczne adresy IPv4
Procedura zaczyna się od konwersji zakresów IP w notacji CIDR na właściwe, atomowe adresy IP. Ponieważ zakresy są reprezentowane liczbowo, możemy do tego użyć klasy Range z Ruby:
def convert_ip_range(start_ip, end_ip)
  start_ip = IPAddr.new(start_ip)
  end_ip   = IPAddr.new(end_ip)
  (start_ip..end_ip).map(&:to_s)
end
Właściwe zadanie generujące adresy z zakresów wygląda jak poniżej. Pierwotnie zadanie to było przystosowane do generowania adresów z zakresów dla krajów z pulą mniejszą niż 5 milionów adresów – takich terytoriów jest około 200.
  desc "Generate and insert IP list based on IP2Location IP ranges"
  task :generate_ip_list_from_ip_range => :environment do
    sql = "SELECT country_code, SUM(ip_to-ip_from) AS cnt
            FROM ip2location_db11
            WHERE country_code IN
              (
                SELECT DISTINCT a.country_code
                FROM ip2location_db11 a
                LEFT JOIN servers b ON a.country_code = b.country_code
                WHERE b.country_code IS NULL
              )
              AND country_code = 'RU'
            GROUP BY country_code;"
    res = IpAddress2.connection.execute(sql) # ip2location_db11
    res.each do |r|
      puts r.inspect
      ranges = IpAddress2
                .where("country_code = ?", r["country_code"])
                .select("'0.0.0.0'::inet + CAST(ip_from AS bigint) AS mfr,
                         '0.0.0.0'::inet + CAST(ip_to AS bigint) AS mto,
                	  country_code, country_name, region_name, city_name,
                          latitude, longitude, zip_code, time_zone")
      ranges.each_with_index do |range,index|
        puts "from: #{range.mfr}, to: #{range.mto}"
        if !range.mfr.blank? && !range.mto.blank? then
          ips = convert_ip_range(range.mfr.to_s, range.mto.to_s)
          elements = []
          cnt = 0
          ips_size = ips.size
          puts " ips_size: #{ips_size.to_s}"
          ips.each_with_index do |ip,index2|
            s = Server.new
            s.ip = ip
            s.country_code     = range.country_code
            s.geo_region_name  = range.region_name.gsub("'", "")
            s.geo_city_name    = range.city_name.gsub("'", "")
            s.geo_latitude     = range.latitude
            s.geo_longitude    = range.longitude
            s.geo_zip_code     = range.zip_code
            s.geo_time_zone    = range.time_zone
            cnt = cnt + 1
            elements << s
            if cnt >= 500 || index2+1 == ips_size then
              puts " #{cnt.to_s}: importing #{elements.size.to_s}"
              Server.import(elements, returning: :ip)
              elements = []
              cnt = 0
            end
          end # ips
        end # if blank
      end # IP ranges
    end # SQL res
  end # task
Generowanie zakresów ma kilka niedoskonałości. Końcowa liczba wynikowych adresów jest większa niż deklarowana przez ip2location i nie wynika to z generowania adresów podsieci i broadcastu. Jednak w ogólnej skali ma to niewielkie znaczenie. Generowanie w tej postaci trwa kilka godzin w zależności od przyjętej wielkości paczki batch (500, 1000 lub innej).
Skanowanie serwerów HTTP za pomocą zmap #
Kwalifikacja ilościowa za pomocą zmap
Są dwa podejścia do przeprowadzenia skanu i nie chodzi o rozróżnienie, czy skanujemy z innej lokalizacji niż nasza, czy skanujemy w wolnym tempie. Chodzi o tryb uruchomienia. Możemy skanować szeregowo lub równolegle. Skanowanie szeregowe jest wolne, a scalanie zakresów trudno wykonać w krótkim czasie. Możemy spróbować scalić mniejsze zakresy (podsieci /24) w większe (np. /16) za pomocą modułu Ruby NetAddr:
result = NetAddr.summ_IPv4Net(cidrs)Niestety kod tego modułu jest nieoptymalny i nie wykonuje się poprawnie z powodu błędów pamięci, luk i ogólnie ogromnego czasu przetwarzania. Być może kiedyś znajdę chwilę, by napisać alternatywę, ale problem jest tylko pozornie prosty. W każdym razie, aby wygenerować zakres CIDR z zakresu liczbowego, ponownie potrzebujemy fragmentu kodu jak poniżej:
 def iprange2netmask(ipstart, ipend)
    if ipstart.kind_of?(String) || ipend.kind_of?(String)
      startR = ip2long(ipstart)
      endR = ip2long(ipend)
    else
      startR = ipstart
      endR = ipend
    end
    result = Array.new
    while endR >= startR do
      maxSize = 32
      while maxSize > 0 do
        mask = (iMask(maxSize - 1))
        maskBase = startR & mask
        if maskBase != startR
          break
        end
          maxSize-=1
      end
      x = Math.log(endR - startR + 1)/Math.log(2)
      maxDiff = (32 - x.floor).floor
      if maxSize < maxDiff
        maxSize = maxDiff
      end
      ip = long2ip(startR)
      netmask = cidr2netmask(maxSize)
      cidr = [ip, netmask].join('/')
      result.push("#{ip}/#{maxSize.to_s}")
      startR += 2**(32-maxSize)
    end
    return result
  end
  def iMask(s)
    return (2**32 - 2**(32-s))
  end
  def long2ip(num)
    return IPAddr.new(num, Socket::AF_INET).to_s
  end
  def ip2long(ip)
    return IPAddr.new(ip).to_i
  end
  def cidr2netmask(cidr)
    IPAddr.new('255.255.255.255').mask(cidr).to_s
  end
Mając gotową metodę zamiany zakresu liczbowego na zakres CIDR, możemy wygenerować skrypty skanujące za pomocą poniższego zadania. Zadanie tworzy niezbędną strukturę katalogów, w której zostaną umieszczone skrypty wykorzystujące program zmap. Parametry użyte do skanowania to przepustowość 100 Mbps i 2 próby. W konfiguracji zmap w pliku /etc/zmap/zmap.conf wskazałem też czas oczekiwania na odpowiedź w parametrze cooldown-time równym 2 sekundy.
 desc "zmap to port X"
  task :generate => :environment do
    port = 80
    countries = Server.all
                  .select("country_code, count(*) AS cnt")
                  .group("country_code").order(Arel.sql("COUNT(*) ASC"))
    countries.each do |c|
      puts "#{c.country_code}: #{c.cnt}"
      ranges = IpAddress2
                 .where("country_code = ?", c.country_code)
                 .select("'0.0.0.0'::inet + cast(ip_from AS bigint) AS mfr,
                          '0.0.0.0'::inet + CAST(ip_to AS bigint) AS mto, country_code")
      if Dir.exist?("/opt/repos/zmap/#{port}/{c.country_code}") then
        next
      else
        FileUtils.mkdir_p("/opt/repos/zmap/#{port}/#{c.country_code}")
        FileUtils.mkdir_p("/opt/repos/zmap/#{port}/#{c.country_code}/scripts")
        FileUtils.mkdir_p("/opt/repos/zmap/#{port}/#{c.country_code}/scripts/done")
        FileUtils.mkdir_p("/opt/repos/zmap/#{port}/#{c.country_code}/results")
      end
      ranges.each_with_index do |range,index|
        path = "/opt/repos/zmap/#{port}/#{c.country_code}/scripts/run_#{range.mfr}_#{range.mto}.sh"
        iprange2netmask(range.mfr.to_s, range.mto.to_s).each_with_index do |cidr,index2|
          puts "RANGE: #{range.mfr} do #{range.mto}"
          command = "zmap --bandwidth=100M --target-port=#{port}
           --output-file=/opt/repos/zmap/#{port}/
                         #{c.country_code}
                         /results/#{range.mfr}_#{range.mto}.csv
           --probes=2 #{cidr}\n"
          File.write(path, command, mode: "a")
        end # cidrs
        command2 = "ping -c 1 1.1.1.1\n"
        File.write(path, command2, mode: "a")
        command3 = "if [ $? -eq 0 ];
                    then mv #{path} /opt/repos/zmap/#{port}/#{c.country_code}/scripts/done;
                    else echo '!';
                    fi\n"
        File.write(path, command3, mode: "a")
      end # ranges
    end # countries
  end # task
Niezależnie od tego, jak uruchomimy zadanie, szeregowo czy równolegle, napotkamy te same problemy, jeśli chodzi o kompletność uzyskanych wyników. Mowa o czasie oczekiwania na odpowiedź. Domyślnie zmap czeka do 8 sekund, co oznacza sporo opóźnień przy wielu podsieciach z maską CIDR /24. Przeskanowanie 256 hostów (minus adres sieci i adres broadcast) trwa mgnienie oka, więc późniejsze oczekiwanie przez 8 sekund jest tu zdecydowanie zbędne. Jednocześnie, jeśli ustawimy ten parametr na 1 sekundę, może się okazać, że tracimy poprawne odpowiedzi, które nie dotarły do nas z powodu opóźnień w sieci szkieletowej, a nawet w naszej sieci lokalnej.
Jeśli nie chcemy agresywnie optymalizować konfiguracji pfSense pod kątem wydajności stanów, musimy zwiększyć pamięć RAM, tak aby zmieściły się wszystkie nadmiarowe stany. Aby móc uruchomić taki skan, potrzeba co najmniej 4 GB. Wszystko powyżej zwiększa możliwości, a najlepiej mieć 16 GB. Przy okazji będziemy mieli okazję się przekonać, tak jak ja, że pfSense ma specjalne mechanizmy optymalizacji, gdy liczba stanów przekracza określone progi.
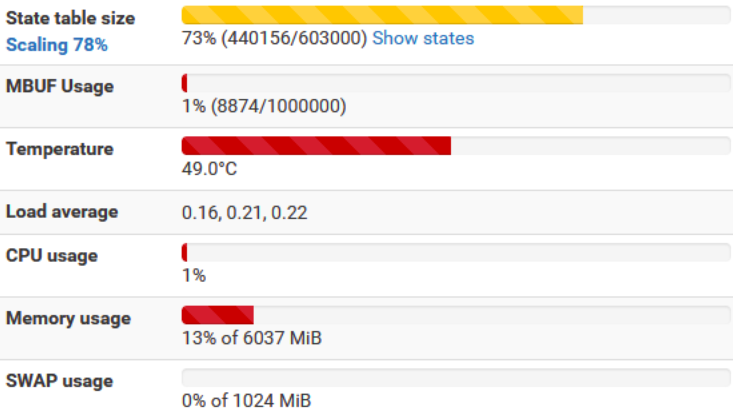
Przetwarzanie równoległe uzyskałem dzięki bibliotece Parallel . Metodą prób i błędów ustaliłem, że przy 6 GB pamięci optymalne będzie użycie 4 procesów. Próbowałem też wyższych wartości, np. 16 procesów, ale musiałbym zainstalować w pfSense 16, a nawet 32 GB pamięci. Mogłoby to też negatywnie wpłynąć na korzystanie z sieci lokalnej jako takiej. Do przetwarzania równoległego użyłem następującego zadania.
  desc "run zmap in parallel"
  task :run => :environment do
    country_code = "RU"
    port         = 80
    scripts = Dir["/opt/repos/zmap/#{port}/#{country_code}/scripts/*"]
    Parallel.map(scripts, in_processes: 4) do |script|
      puts "#{Parallel.worker_number} => #{script}"
      system(script)
    end
  end
Skanowanie trwało 20 godzin. W tym czasie zmap wysłał zaledwie 5 GB pakietów danych. Przeskanowano 45 milionów atomowych adresów IP z 68 tys. zakresów i 177 tys. sieci najniższego rzędu. Wynikiem jest 630 tys. adresów nasłuchujących na porcie 80. Nie oznacza to, że działają tam serwery HTTP, a jedynie, że serwer odpowiada na pakiety wysyłane przez zmap. Jest to kwalifikacja ilościowa. W ostatnim kroku wyniki zostały przeniesione do bazy danych, do dedykowanej tabeli opartej na wynikach.
Uwaga: z własnego doświadczenia wiem, że skany zmap można wykryć za pomocą sygnatur w aplikacjach IPS / IDS, takich jak Suricata. Być może więc część hostów nie odpowiedziała, ponieważ w trybie proaktywnym wykryła, że przeprowadzany jest skan zmap. Pewne jest, że tego rodzaju system może przez jakiś czas blokować dalszą komunikację z adresu źródłowego. Dobrą praktyką jest więc odczekanie 24 godzin przed próbą weryfikacji jakościowej tych hostów.
Weryfikacja jakościowa #
Analiza treści oferowanych przez zdalne hosty
Pracę z serwerami HTTP zacząłem od stwierdzenia, że przy tak dużej populacji hostów występuje zbyt duże zróżnicowanie implementacji protokołu, by wystarczyło użycie prostej i wygodnej biblioteki HTTParty. Od razu było widać, że potrzebuję dedykowanej metody, która nie będzie czyniła daleko idących założeń co do działania zdalnego hosta. Oto kod.
module FetchUtil
  # Fetch a URL, with a given max bytes, and a given timeout
  def self.fetch_url url, timeout_sec=4, max_bytes=1*1024*1024
    uri = URI.parse(url)
    t0 = Time.now.to_f
    body = ''
    code = nil
    headers = []
    Net::HTTP.start(uri.host, uri.port,
               :use_ssl => (uri.scheme == 'https'),
               :open_timeout => timeout_sec,
               :read_timeout => timeout_sec) { |http|
      # First make a HEAD request and check the content-length
      check_res = http.request_head(uri.path)
      code = check_res.code
      raise "File too big" if check_res['content-length'].to_i > max_bytes
      # Then fetch in chunks and bail on either timeout or max_bytes
      # (Note: timeout won't work unless bytes are streaming in...)
      http.request_get(uri.path) do |res|
        res.each_header do |k,v|
          headers << [k,v]
        end
        res.read_body do |chunk|
          raise "Timeout error" if (Time.now().to_f-t0 > timeout_sec)
          raise "Filesize exceeded" if (body.length+chunk.length > max_bytes)
          body += chunk
        end
      end
    }
    return [code, body, headers]
  end # fetch_url
end # module
Ten kod ma dwa ograniczenia: rozmiar i czas. Ograniczamy rozmiar do 1 MB danych i 4 sekund oczekiwania na wynik. Jest to część większego zadania odpowiedzialnego za współbieżną weryfikację. Używany jest opisany wyżej moduł, ale także HTTParty, gdy pojawia się kod odpowiedzi 3xx. Próbuję też konwertować kodowanie ASCII-8BIT na UTF-8, ale to bardzo obszerny temat, zwłaszcza że wybrane terytorium nie używa alfabetu łacińskiego.
def perform_verify
    @reconnected ||= Server.connection.reconnect! || true
    port = 80
    Parallel.each_with_index(Server80.where("is_checked is false ")
            .limit((1024*64)), in_processes: ENV['PC'].to_i * 1) do |s,index|
      $stdout.sync = true
      @reconnected ||= Server80.connection.reconnect! || true
      puts "#{Parallel.worker_number}: #{index}: (#{ENV['PC'].to_i*1}): #{s.ip}: #{s.country_code}"
      start = Time.now
      begin
        resp     = FetchUtil.fetch_url("http://#{s.ip}:#{port}/")
        code     = resp[0]
        body     = resp[1]
        hdrs     = resp[2]
        if code.to_s[0] == '3' then
          puts " switching to httparty as 3xx"
          response = HTTParty.get("http://#{s.ip}:#{port}", timeout: 2)
          code = response.code
          body = response.body
          hdrs = response.headers
        end
        if true
          str = body
          enc = body.encoding rescue nil
          puts " #{enc}"
          if enc.to_s == "ASCII-8BIT" then
            str = body.force_encoding(enc).encode('utf-8', invalid: :replace, undef: :replace)
            str.scrub!("")
            str.gsub!(/[[:cntrl:]&&[^\n\r]]/,"")
          end
          doc = Nokogiri::HTML(str)
          s.headers  = hdrs
          s.content  = str
          s.csize    = str.size
          s.title    = doc.xpath("//title").text
          s.start    = start
          s.finish   = Time.now
          s.diff     = (s.finish - s.start).in_milliseconds
          s.result   = code[0..999]
          if    code.to_s[0] == '1' then
            s.is_1xx = true
          elsif code.to_s[0] == '2' then
            s.is_2xx = true
          elsif code.to_s[0] == '3' then
            s.is_3xx = true
          elsif code.to_s[0] == '4' then
            s.is_4xx = true
          elsif code.to_s[0] == '5' then
            s.is_5xx = true
          end
          puts " .. #{s.result} -#{s.result.size}- .. #{s.title} .."
          s.is_checked = true
          s.save!
        end
      rescue Exception => e
        puts " exception: #{e}"
        s.content = nil
        s.title = nil
        s.result = e.to_s[0..999]
        s.is_checked = false
        s.is_http_error = true
        s.save!
      end
    end # parellel
  end # task
Do przetwarzania odpowiedzi używam Nokogiri i selektorów xpath. Gdy działało zadanie z 24 procesami, liczba stanów na pfSense wynosiła od 30 tys. do 40 tys.. Połączenie Parallel i HTTParty oraz kontaktu z nieznanymi hostami często powoduje blokowanie się procesów. Wygląda na to, że głównym winowajcą jest tu Parallel i jego kompatybilność z innymi elementami, ponieważ takie zachowanie obserwuję też w innych projektach, w których nie jest używana biblioteka HTTParty, a jedynie ActiveRecord. Istnieje opcja pełnej separacji procesów, ale powoduje ona drastyczny spadek wydajności, co w zasadzie dyskwalifikuje tę opcję. Jest też inne wyjaśnienie, które może częściowo tłumaczyć to zachowanie. Otóż część hostów oferuje usługi strumieniowe, które trudno zidentyfikować. Mogą wysyłać fałszywe metadane HTTP, a w rzeczywistości oferować coś zupełnie innego.
Przechodząc do analizy wyników: poprawną odpowiedź wysłało 522 tys. hostów plus 8 tys. hostów w ponowieniu. Daje to łącznie 530 tys. poprawnych odpowiedzi i 99 tys. różnego rodzaju błędów połączenia na protokole HTTP. Wykonałem 5 pełnych przebiegów, aby potwierdzić, że hosty z błędami rzeczywiście trwale nie oferują żadnej treści HTTP. 16% hostów, które odpowiedziały na porcie 80, jest niepoprawnych. Podział wśród niepoprawnych odpowiedzi jest następujący.
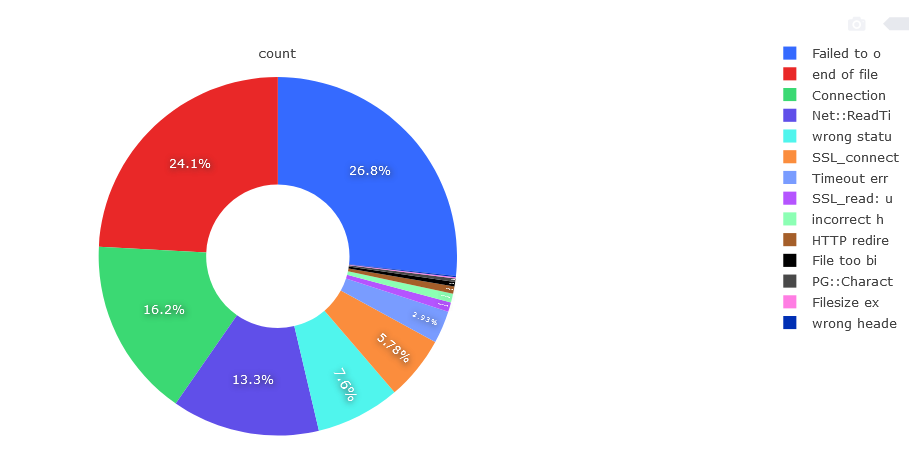
„Failed to open TCP connection” odpowiada za największą część błędów, 26,8%, 26398 pozycji. Drugi w kolejności jest „end of file reached”, 24,1%, 23817 sztuk. Trzecie miejsce zajmuje „Connection reset by peer”, 16,2%, 15986 sztuk. Dalej są Net :: ReadTimeout, „wrong status line”, SSL_connect, TimeoutError, SSL_read, HTTP redirects, „File too big”. Pozostałe komunikaty błędów odpowiadają za niewielki odsetek, a ich typów jest bardzo wiele. Wynikają z uruchamiania usług innych niż HTTP na portach 80 i 443. Poprawne odpowiedzi HTTP, czyli pula 530 tys. hostów, dzielą się następująco.
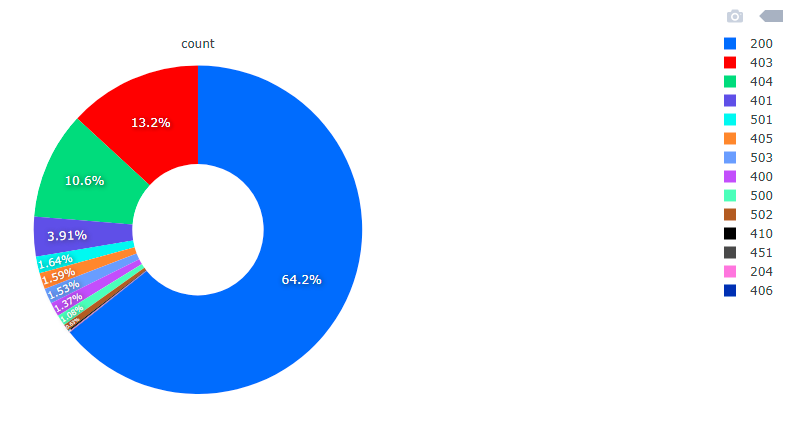
Kody odpowiedzi HTTP dzielą się na 5 kategorii. Kody zaczynające się od 1 to kody informacyjne. Kody zaczynające się od 2 to poprawne odpowiedzi. Kody zaczynające się od 3 to przekierowania różnego typu, wymagana jest dodatkowa akcja. Kody zaczynające się od 4 to błędy klienta, które uniemożliwiają dalsze przetwarzanie żądania. Kody zaczynające się od 5 to błędy serwera. Listę kodów odpowiedzi HTTP prowadzi IANA.
Kodów HTTP 200 jest 340 tys.. Mamy 69 tys. kodów 403. Mamy 56 tys. kodów 404. Mamy 20 tys. kodów 401. Pozostała grupa kilkunastu typów odpowiedzi to poniżej 10 tys. dla każdego z tych typów.
Analiza wyników #
Konfiguracja i treść
Treść oferowaną przez serwery HTTP możemy rozpatrywać z kilku perspektyw. Przede wszystkim należy zauważyć, że mówiąc o publicznych adresach IPv4, mówimy o fizycznych lub wirtualnych kartach sieciowych. W obu przypadkach na danym hoście może działać wiele domen w oparciu o SNI. Hosty te mogą pełnić i z pewnością pełnią funkcję punktów wejścia do podsieci (NAT lub proxy). Oczywiście nie dotyczy to wszystkich adresów, a jedynie części. Których – nie wiadomo. Analiza może dotyczyć serwera HTTP jako takiego, jego typu, wersji i konfiguracji, albo treści zwracanej przez ten serwer. Obie analizy przynoszą wiele ciekawych faktów.
Analiza konfiguracji #
Systemy operacyjne i platformy uruchomieniowe
Badając konfigurację, stwierdzam, że spośród wszystkich odpowiedzi 217 tys. hostów obsługuje serwer NGINX, 96 tys. serwer Apache, a 20 tys. serwer Microsoft IIS. Najpopularniejsze serwery HTTP odpowiadają łącznie za 334 tys. adresów. Jest 7810 odmian wszystkich zgłaszanych serwerów. Ciekawsze z mniej popularnych serwerów to Webrick, Lotus-Domino czy Mongrel, ale też MinIO i WowzaStreamingEngine. Są też serwery wydruku, Couchbase i wiele innych. Z serii tych dziwnych wyróżniłbym „Aeroflot”, „Stalin” czy „ZX Spectrum”. Jeśli jednak miałbym wskazać coś konkretnego, powiedziałbym, że to NGINX 0.4.13 z 2006 roku czy Phusion Passenger w starszej wersji. Ogólnie rzecz biorąc, wszystkie starsze wersje serwerów HTTP mogą być celem narzędzi exploitujących.
Innym aspektem badania konfiguracji są systemy operacyjne i platformy uruchomieniowe, na których działają hosty i serwery HTTP. Serwerów z deklarowanym systemem Windows jest 5257 sztuk. Dla porównania Ubuntu Linux to 52473 sztuki, Debian to 16438 sztuk. Spośród innych popularnych systemów jest to CentOS w liczbie 31176 sztuk. Popularny jest także system FreeBSD, łącznie 3326 sztuk. Najpopularniejszym stosem technologicznym, o którym wiemy z nagłówków, jest PHP. Nie jest to jednak informacja potwierdzona, ponieważ w zasadzie tylko moduł tego języka jest szeroko rozgłaszany, a pozostałe po prostu nie. Takiej informacji nie znajdziemy w przypadku języków Java czy Ruby. Wyjątkiem będzie Perl jako moduł Apache. Występuje w 662 sztukach.
Informacja o systemie operacyjnym lub platformie uruchomieniowej, a w szczególności o ich wersjach, jest istotna z punktu widzenia bezpieczeństwa takich hostów. Host z Linuksem lub FreeBSD jest tak samo podatny jak host z Windows . Wynika to z tego, że mogą być przede wszystkim źle skonfigurowane , a niekoniecznie podatne. Systemy Windows są znacznie popularniejsze na stacjach roboczych niż na serwerach, stąd znaczna większość zagrożeń obecnych w tym systemie. Jeśli chodzi o podatności, pierwszym wyborem jest metasploit, który da nam informację, czy podatności na hostach można wykorzystać.
Uwaga: ważne jest, by wiedzieć, że „Data Mining & Exploration” dotyczy informacji i ustalania faktów, a nie łamania zabezpieczeń i wykorzystywania błędnych konfiguracji.
Analiza treści #
Systemy i aplikacje
Oprócz konfiguracji serwerów możemy zbadać, jaką treść zwracają. Pozwala nam to lepiej poznać specyfikę badanego regionu. Inne usługi uruchamiane są bowiem w Europie, inne w Azji, a jeszcze inne w Afryce. Są pewne punkty wspólne, ale ogólnie poziom rozwoju danego terytorium ma wpływ na to, ile i jakich usług możemy tam znaleźć w przestrzeni internetowej. Treść analizuję, szukając kilku najpopularniejszych systemów, które najczęściej mogą być niepoprawnie skonfigurowane. Są to GitLab, Kibana i Elasticsearch, serwery plików, Zabbix i Grafana. W każdym z nich może wystąpić sytuacja otwartej rejestracji, braku kontroli dostępu lub aktywnego konta gościa.
GitLab #
Zaczynając od GitLaba , znalazłem 598 instalacji. Na kilku z nich spróbowałem rejestracji. Większość wymagała potwierdzenia konta przez administratora, ale na kilku udało mi się zarejestrować i od razu mieć aktywne konto z dostępem do zasobów. Przez zasoby rozumiem głównie repozytoria kodu. Szacuję, że w pełni funkcjonalne konto można by uzyskać na około 5-10% instalacji.
Uwaga: pozwolę sobie nie podawać konkretnych adresów. Co prawda poinformowałem administratorów tych instalacji o błędzie konfiguracji, ale żaden z nich nie odpowiedział na moje zgłoszenie. Mogą to być porzucone instalacje lub kontakt jest nieaktualny.
Elasticsearch, Kibana #
Drugim systemem, którego szukałem, była Kibana połączona z Elasticsearch. To, że istnieją instalacje na porcie 80, uważam za oczywisty przykład błędu konfiguracji, ponieważ domyślnie Kibana działa na porcie 5601, więc ktoś musiał ją przekonfigurować albo ustawić reverse proxy.
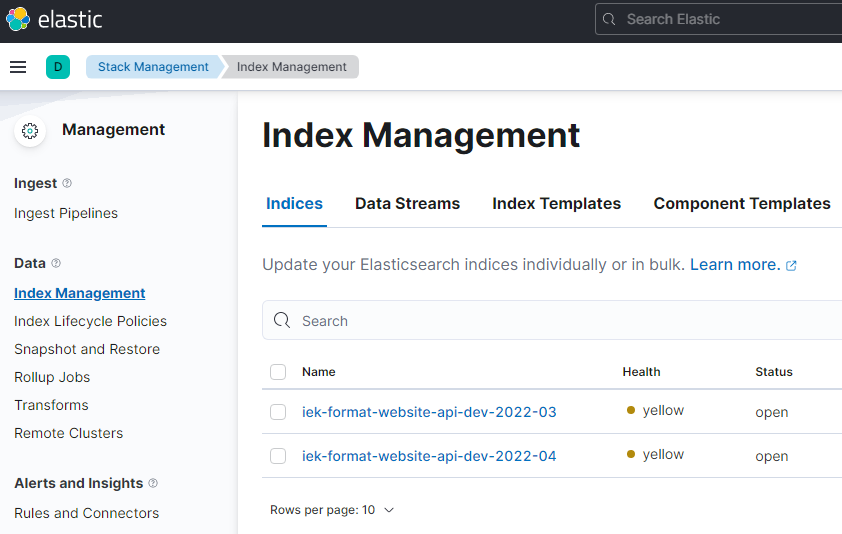
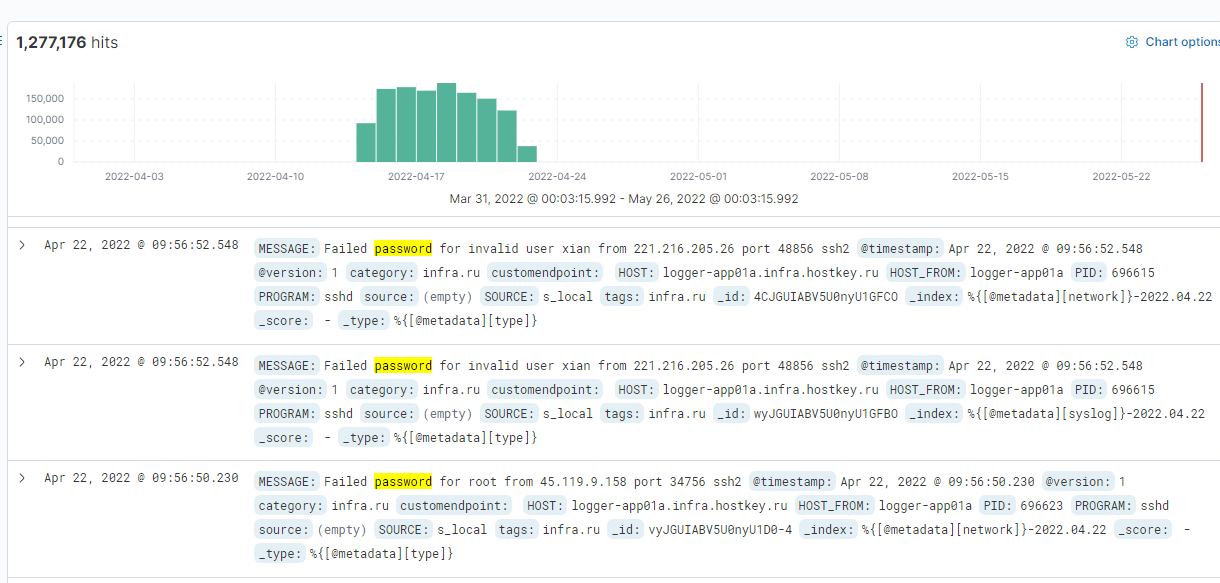
Udostępnienie Kibany może skutkować wyświetleniem indeksów (logów, metryk i pakietów sieciowych), łącznie z możliwością ich pobrania, a nawet usunięcia. Domyślnie interfejs nie pozwala pobrać zawartości indeksów, ale przy użyciu odpowiedniego narzędzia konsolowego będzie to możliwe. Często, jeśli na porcie 80 jest Kibana, to na portach 9200 i 9300 działają usługi Elasticsearch, również publicznie dostępne. W ramach systemów Elasticsearch i Kibana mamy jeszcze jedną usługę, a mianowicie serwer APM, czyli monitoring aplikacji.
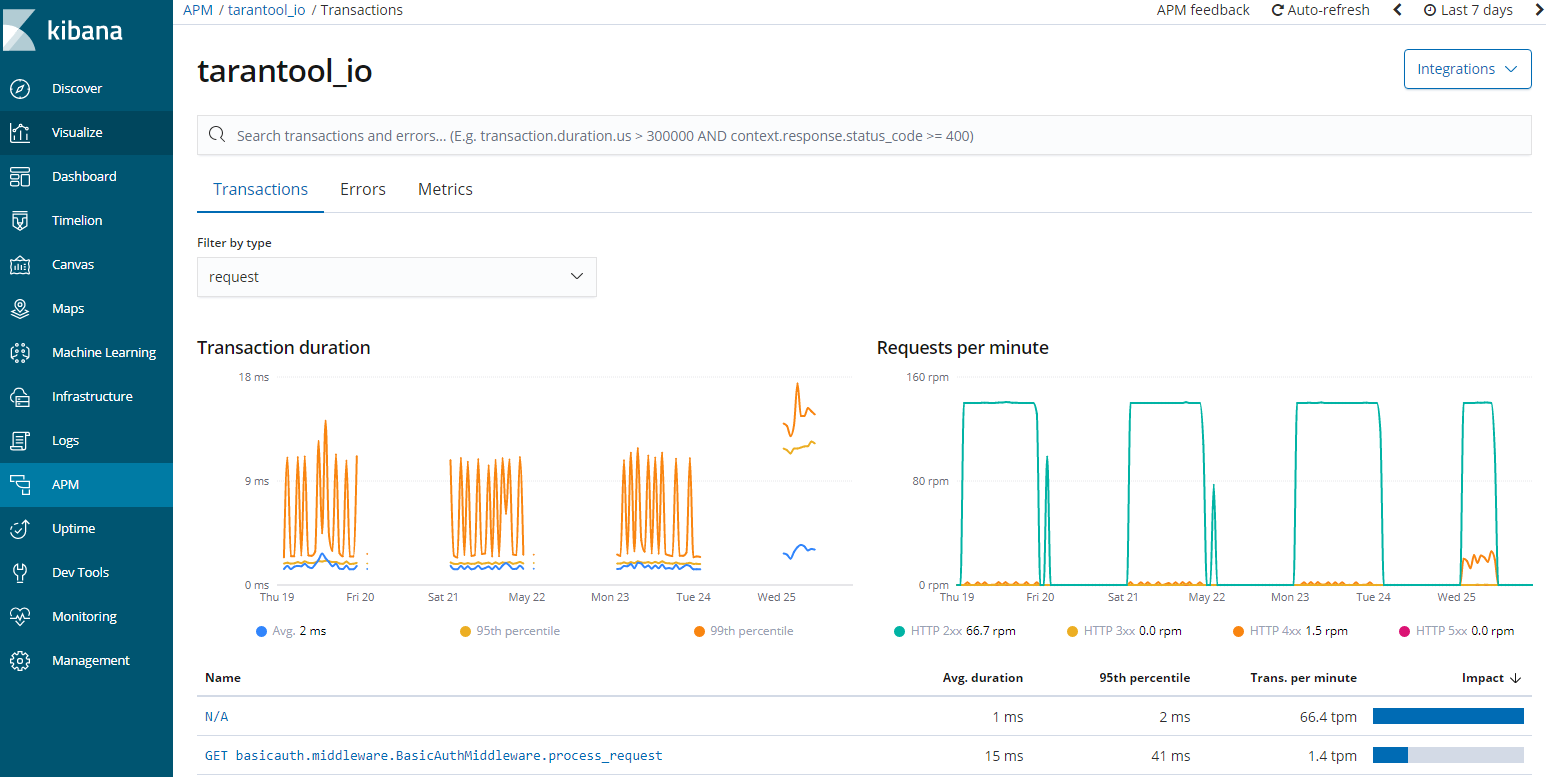
Ujawnienie danych diagnostycznych aplikacji zwiększa możliwości eksploracji takiej aplikacji, ponieważ APM dostarcza informacji o bazie danych, powiązanych usługach i adresach, na których aplikacja działa w warstwie HTTP. Elasticsearch, beats i Kibana to potężne narzędzie, które może dać nam wiele informacji w formie rozpoznania środowiska sieciowego.
Listingi plików #
Trzecim typem zasobów są magazyny plików w postaci listingów plików na serwerze HTTP . Znalazłem prawie 3000 takich instalacji. Wśród ciekawszych znalezisk mogę wymienić kopie baz danych, archiwum monitoringu wizyjnego czy repozytoria kodu . Są też skany dokumentów, potwierdzenia przelewów bankowych, certyfikaty i wiele innych. Niektórzy użytkownicy tych serwerów mogą nie wiedzieć, że mają publiczny adres IP. Ich IP może być dynamiczny, ale publiczny. Drugą kategorią są osoby, które myślą, że tylko one znają ten adres IP, co jest oczywistym błędem, bo adresy są powszechnie znane.
Uwaga: adresy domenowe (zwłaszcza subdomeny) nie są powszechnie znane, chyba że mówimy o odwrotnym mapowaniu DNS. Kwestia DNS to materiał na kolejny artykuł.
Zabbix #
Czwartym typem jest 636 instalacji systemu monitoringu Zabbix. Powinien on znajdować się w sieci prywatnej z dostępem za WAF lub VPN, ale w tych przypadkach tak nie jest. Co więcej, wiele z nich pozwala na dostęp z konta gościa. Zasadniczo to błąd, że takie dane są publicznie dostępne, ponieważ identyfikują system na wielu warstwach.
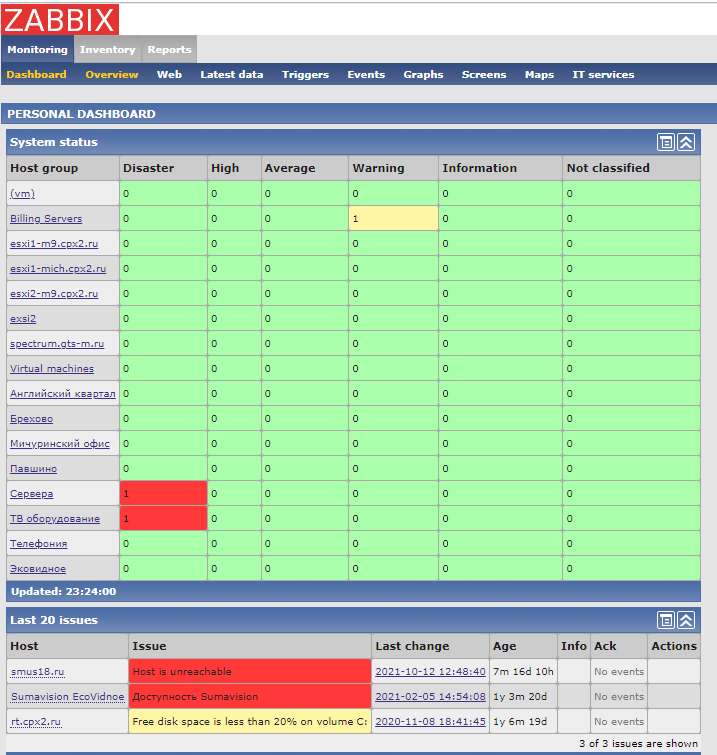
Dowiadujemy się, że systemy działają na VMware, jaki jest logiczny podział aplikacji itp. Uzyskujemy informacje o adresacji. Może to być podstawą do dalszej eksploracji tej konkretnej organizacji.
Grafana #
Podobnie jak w przypadku Kibany i Zabbixa, również Grafana, jeśli nie jest zabezpieczona, dostarcza nam wielu cennych informacji o infrastrukturze systemu, adresacji i wykorzystaniu zasobów. Jest to baza do dalszej eksploracji.

Sytuacja jest tym ciekawsza, że mamy możliwość tworzenia własnych ekranów, na których możemy umieszczać panele sterowania czy wielopoziomowy monitoring. Tak jest też w przypadku najciekawszego przykładu znalezionego w tym przebiegu skanowania. Jest to panel monitoringu i sterowania urządzeniami grzewczymi.
Widziałem różne panele, głównie związane z monitoringiem wizyjnym, turbinami wiatrowymi czy fotowoltaiką, ale takiego wcześniej nie spotkałem. Skoro ktoś udostępnia monitoring i przyciski do wykonywania różnych akcji (na innym panelu), przypuszczam, że może to mieć wpływ na działanie fizycznych urządzeń. Wkraczamy więc na niebezpieczny obszar, bo urządzenia pracują przy wysokiej temperaturze i ciśnieniu i byłoby źle, gdyby pracowały poza parametrami. Prawda?
Uwaga: część systemów udostępnionych publicznie to systemy testowe lub porzucone. Niektóre to ewidentnie systemy typu honey-pot. Większość, a właściwie prawie wszystkie, to jednak systemy produkcyjne lub takie, które za jakiś czas staną się produkcyjne. Niezależnie od ich charakteru nie powinny być dostępne publicznie, bo jest to sprzeczne z dobrymi praktykami.
Na koniec #
Turecka giełda kryptowalut
Dla tych, którym udało się dotrwać do końca tego artykułu, będzie jeszcze jedna ciekawostka. Otóż w 2021 roku, gdy podejmowałem pierwsze próby skanowania, w 200 terytoriach znalazłem coś ciekawszego niż opisane tu znaleziska. Skanowanie nie obejmowało Turcji, lecz kraj, w którym znajdowała się turecka giełda kryptowalut. Znalazłem system monitoringu logów, który przechowywał nazwy użytkowników i ich hasła. Dane te pozwalały na dostęp do kont . Dlatego tak ważne jest inwentaryzowanie zasobów, sprawdzanie konfiguracji i przeprowadzanie audytów bezpieczeństwa.
Uwaga: opisane eksploracje systemów są jedynie przykładem. Nie obejmują wszystkich możliwych usług ani nawet nie analizują wszystkiego, co zostało zidentyfikowane. Uzyskane informacje i dostępy w żaden sposób nie zostały wykorzystane przeciwko komukolwiek. Żaden z systemów nie został naruszony.
Kontakt #
Jeśli ten artykuł cię zainteresował, nie wahaj się ze mną skontaktować. Jestem otwarty na różne formy współpracy, zarówno komercyjnej, jak i niekomercyjnej, w obszarze infrastruktury, architektury i bezpieczeństwa.