Casssandra: wprowadzenie
Przetłumaczone automatycznie z angielskiego. Przeczytaj oryginał
Rozproszony, partycjonowany, multi-master, przyrostowo skalowany horyzontalnie system zarządzania danymi NoSQL do globalnych, krytycznych zastosowań z petabajtowymi zbiorami danych
Spis treści #
- Dynamo, Amazon, Facebook, Apache…
- Charakterystyka
- Osobliwości Cassandra QL
- Co uważam za interesujące
- Instalacja w Docker/Portainer/Proxmox
- Monitorowanie węzłów
- Analiza danych z Redash
- CQL DDL
- CQL DML
- Zasady projektowania
- Przykładowa aplikacja i zrzucanie commitlogu
Dynamo, Amazon, Facebook, Apache… #
„Niezawodność w ogromnej skali to jedno z największych wyzwań, z jakimi mierzymy się w Amazonie”
źródło: „Dynamo: amazon’s highly available key-value store”
W 2004 roku w obsłudze e-commerce Amazona pojawiły się problemy z wydajnością spowodowane dużym ruchem. Do 2007 roku koncepcja Dynamo zmaterializowała się jako Amazon S3. Następnie w 2008 roku Facebook, wraz ze współautorami Amazon Dynamo, opracował własny rozproszony system NoSQL – Cassandrę. W 2009 roku Cassandra stała się projektem Apache. Natomiast DynamoDB od Amazona pojawiło się w 2012 roku; również korzysta z koncepcji Dynamo, ale jest rozwiązaniem w pełni zamkniętym.
Mamy więc koncepcję Dynamo, mamy Amazona i Facebooka, a w końcu projekt Apache Cassandra. Bez zagłębiania się w szczegóły, kto był pierwszy i kto co od kogo pożyczył… Cassandra jest na rynku już od 16 lat (stan na 2024 rok).
Charakterystyka #
Cassandra jest przeznaczona do uruchamiania w środowisku wielowęzłowym i jest szczególnie przydatna w rozproszonych sieciach. Jest master-less, co oznacza, że nie ma pojedynczego punktu awarii – oczywiście tylko przy właściwie zaprojektowanych keyspace’ach/bazach danych i tabelach, zwłaszcza pod względem współczynnika replikacji. Współczynnik replikacji większy niż 1 oznacza, że wprowadzamy redundancję do układu danych, co prowadzi nas do odporności klastra Cassandry. Choć Cassandra potrafi działać w sposób rozproszony, z perspektywy użytkownika nadal jest widoczna jako pojedyncza całość.
Kluczową koncepcją, która zapewnia niemal nieograniczone możliwości skalowania, jest to, że Cassandra jest rozproszona i korzysta z partycji danych. W porównaniu z RDBMS (takimi jak PostgreSQL) nie potrzebujesz dodatkowej konfiguracji, aby korzystać z partycji i shardów, bo jest to wbudowane w silnik Cassandry. Dane w Cassandrze są umieszczane na konkretnych węzłach z uwzględnieniem klucza partycji. Jeśli potrzebujesz więcej miejsca lub większej mocy obliczeniowej, po prostu dodajesz kolejne węzły do klastra.
„Każdy węzeł jest właścicielem określonego zbioru tokenów, a Cassandra rozkłada dane w klastrze na podstawie zakresów tych tokenów.”
źródło: cassandra.apache.org/_/cassandra-basics.html
Dane są rozkładane w klastrze na podstawie klucza partycji, czyli wartości funkcji skrótu klucza danych, która następnie mapuje się na węzły przechowujące dane tokeny. Każdy węzeł może działać jako koordynator, który szuka węzła docelowego i wymienia się z innymi węzłami informacjami o strukturze klastra (gossip). Oczywiście jest wiele wyzwań, na przykład gdy zdefiniujesz współczynnik replikacji > 1 i pojawią się problemy z siecią. Transakcje mogą się powieść lub nie, w zależności od konfiguracji oraz tego, ile węzłów odpowiedziało na transakcję i ją potwierdziło.
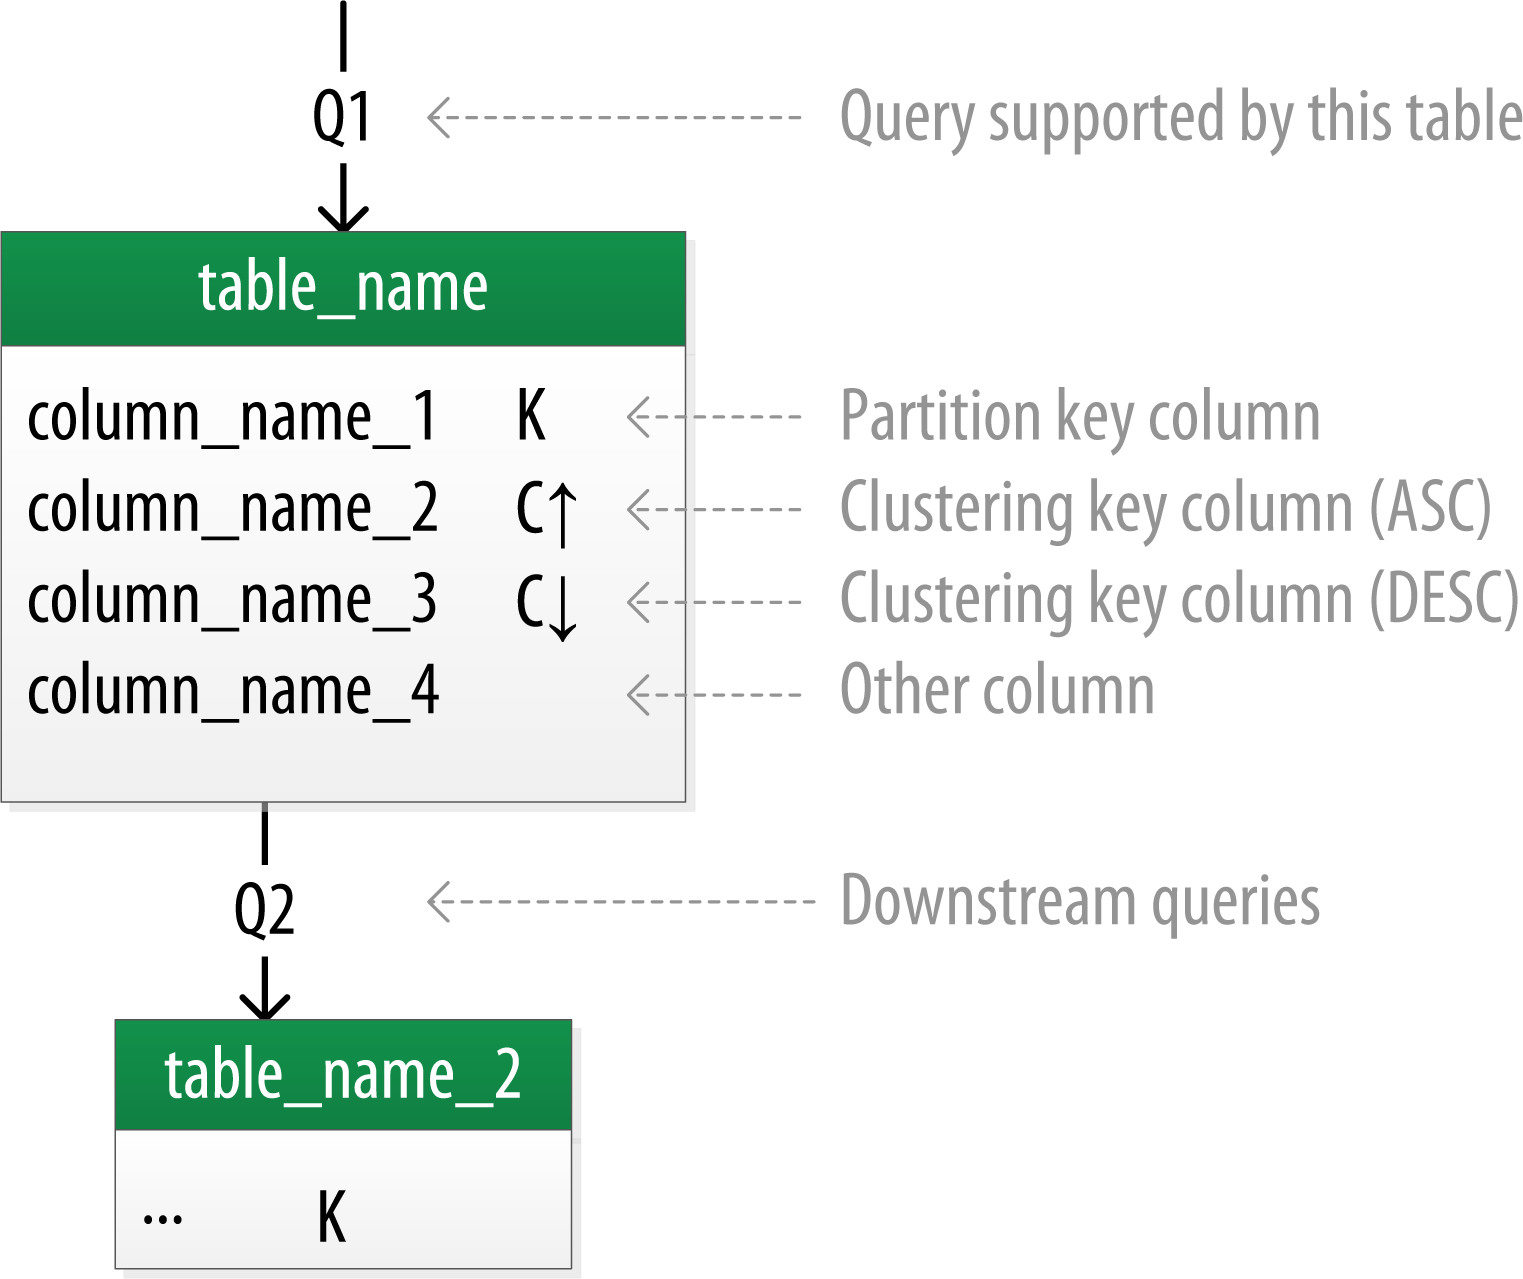
źródło: https://cassandra.apache.org/doc/stable/cassandra/data_modeling/data_modeling_logical.html
Jeśli chodzi o strategię rozmieszczania danych: w środowiskach nieprodukcyjnych lub prostych produkcyjnych możesz użyć SimpleStrategy, natomiast w większych środowiskach produkcyjnych zaleca się NetworkTopologyStrategy, która uwzględnia definicje DC i Rack.
„Modelowanie danych, które uwzględnia wzorce zapytań i przypisuje klucze główne na podstawie zapytań, zapewni najniższe opóźnienia przy pobieraniu danych”
źródło: cassandra.apache.org/doc/stable/cassandra/cql/ddl.html
A jak dane są zorganizowane w plikach?
„Sorted Strings Table (SSTable) to trwały format plików używany przez ScyllaDB, Apache Cassandrę i inne bazy NoSQL, który pozwala wziąć dane przechowywane w pamięci w memtables, uporządkować je pod kątem szybkiego dostępu i zapisać na dysku w trwałym, uporządkowanym, niezmiennym zbiorze plików. Niezmienny oznacza, że SSTables nigdy nie są modyfikowane. Później są scalane w nowe SSTables lub usuwane w miarę aktualizacji danych.”
źródło: www.scylladb.com/glossary/sstable/
Osobliwości Cassandra QL #
Pamiętaj, że…
„Operacje append i prepend z natury nie są idempotentne”
„listy mają ograniczenia i specyficzne uwarunkowania wydajnościowe, które należy wziąć pod uwagę przed ich użyciem”
Obecnie aliasy nie są rozpoznawane w klauzulach
WHEREaniORDER BYzapytania. Zamiast nich trzeba użyć oryginalnej nazwy kolumny.
Klucz główny jednoznacznie identyfikuje wiersz w tabeli, jak opisano powyżej. Konsekwencją tej unikalności jest to, że jeśli zostanie wstawiony inny wiersz z tym samym kluczem głównym, następuje UPSERT i istniejący wiersz o tym samym kluczu głównym zostaje zastąpiony. Kolumny, które nie są częścią klucza głównego, nie mogą definiować unikalności.
…ale ponieważ Cassandra pozwala klientowi podać dowolny znacznik czasu w dowolnej tabeli, teoretycznie możliwe jest stosowanie innej konwencji. Pamiętaj, że jeśli tak zrobisz, usunięcie kolumny nie wykona się poprawnie.
Co uważam za interesujące #
Myślę, że warto zwrócić uwagę na funkcję speculative_retry, która określa, kiedy koordynator zapytania może odpytać inny węzeł o dane w przypadku wolnej odpowiedzi lub niedostępności któregoś węzła.
Warto wypróbować funkcję Vector Search:
Vector Search to nowa funkcja dodana w Cassandrze 5.0. To potężna technika wyszukiwania istotnych treści w dużych zbiorach danych, szczególnie przydatna w aplikacjach AI.
W dokumentacji znalazłem informację, że nie zaleca się uruchamiania Cassandry na NFS/SAN, bo cała rozproszona koncepcja Cassandry opiera się na odseparowanych węzłach. Napisano tam też jednak, że Cassandra będzie działać wydajniej na RAID0 lub JBOD (Just Bunch Of Disk) niż na RAID1 czy RAID5. No cóż… to oczywiste, że rzeczy działają lepiej bez dodatkowego narzutu, i uważam, że należałoby zaznaczyć, iż ta sugestia jest słuszna tylko wtedy, gdy dążymy do maksymalnej wydajności, poświęcając nieco bezpieczeństwa.
Instalacja w Docker/Portainer/Proxmox #
Aby zacząć pracę z Cassandrą, możemy użyć środowiska wirtualnego Proxmox i Docker Swarm z Portainerem na wierzchu. Uruchamianie jej w trybie Swarm wiąże się jednak z pewnymi problemami. Krótko mówiąc, Swarm dodaje dodatkową warstwę ingress, która przydziela kontenerowi dodatkowe adresy IP. To w jakiś sposób dezorientuje Cassandrę. Wierzę, że istnieje na to jakieś rozwiązanie, ale znalazłem tylko kilka zgłoszeń błędów w tej sprawie bez jasnych wniosków.
Możemy więc pozostać w trybie Swarm, ale wdrożyć Cassandrę jako zwykły kontener, a nie usługę. Tak, w trybie Swarm możemy uruchamiać zwykłe kontenery bez umieszczania ich w usługach.
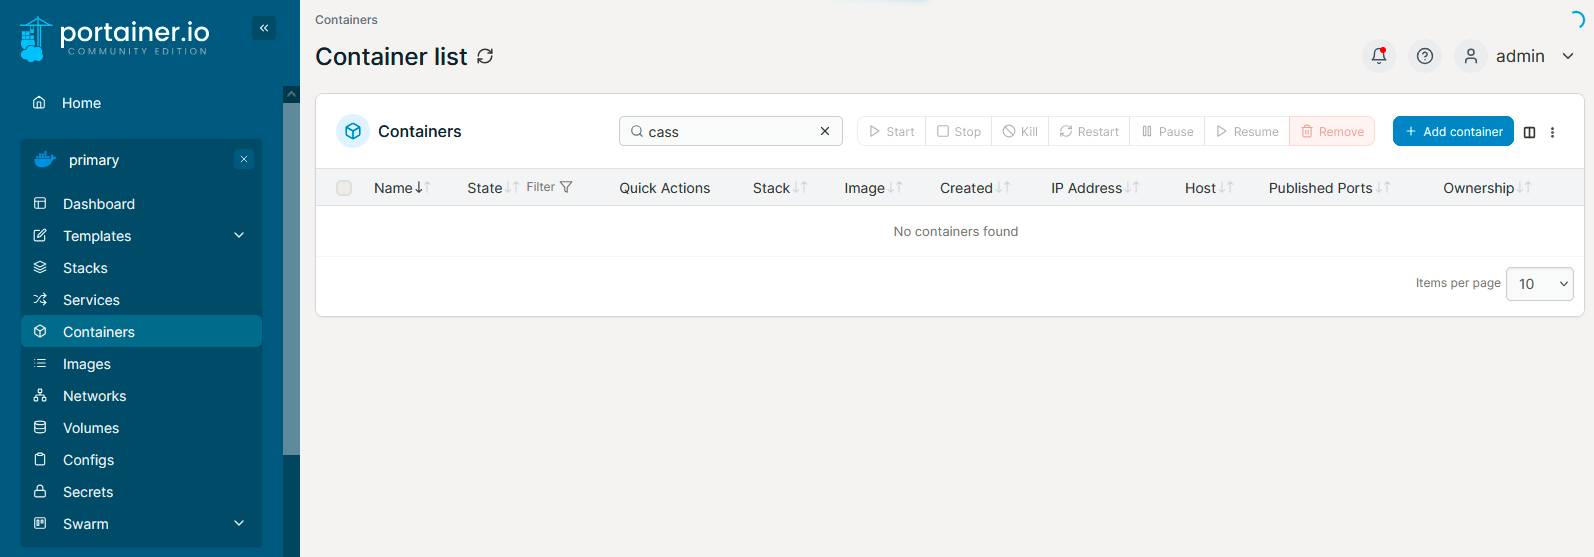
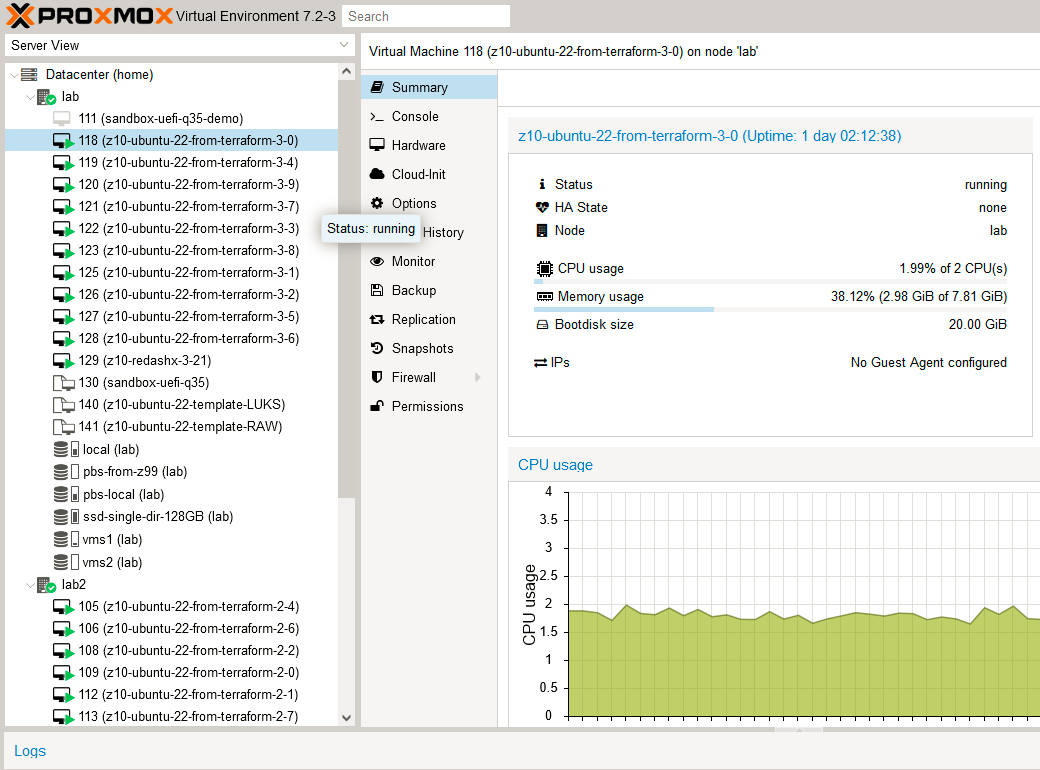
Użyję przygotowanego wcześniej klastra Docker Swarm.
W tym wdrożeniu użyję obrazu Dockera cassandra:5.0.0:
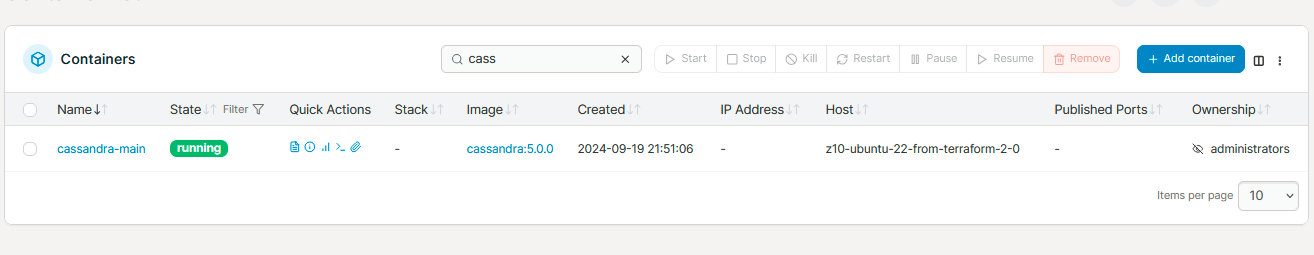
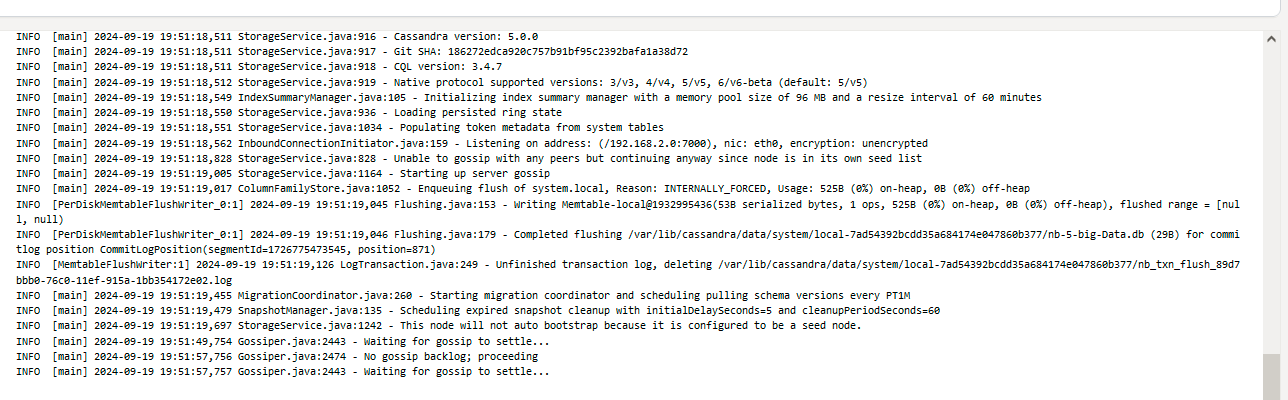
I tak to się zaczyna:
Każdy węzeł Cassandry powinien otworzyć port 7000 do komunikacji między węzłami. Port 9042 służy do obsługi zapytań.
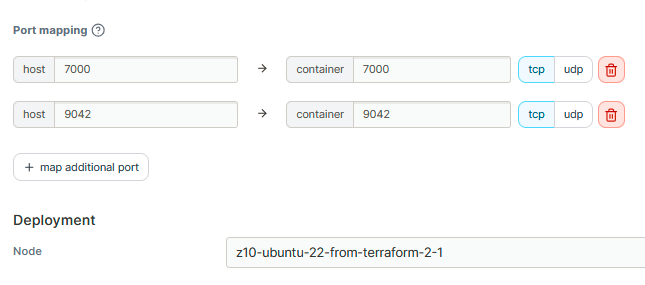
Musimy wskazać konkretny węzeł Docker Swarm, na którym chcemy umieścić węzeł Cassandry. Następnie w sekcji zmiennych środowiskowych definiujemy CASSANDRA_BROADCAST_ADDRESS i CASSANDRA_SEEDS. Ważne jest, aby przekazywać węzły seed w całym klastrze, tak aby w razie awarii wszystko, co pozostało w klastrze, nadal działało.
Monitorowanie węzłów #
Każdy kontener węzła zawiera narzędzie nodetool, które pomaga ustalić stan klastra Cassandry. Możemy sprawdzić ogólny status (polecenie status), szczegółowe informacje (polecenie info), zainicjować kompakcję (polecenie compact) i wiele, wiele więcej.
cd /opt/cassandra/bin
./nodetool status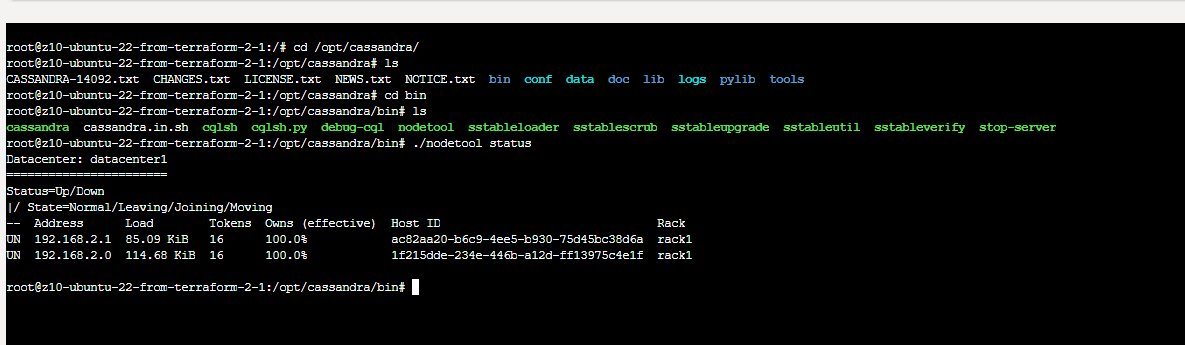
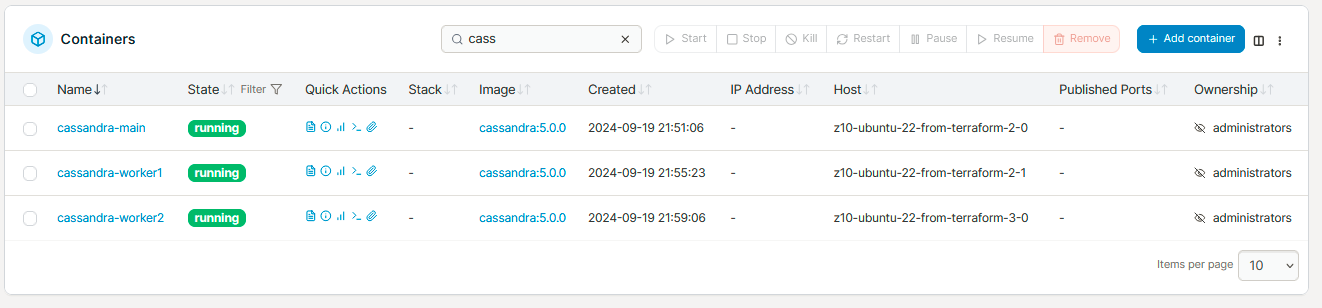
Na potrzeby tego demo zdecydowałem się na klaster z prostą strategią, z jednym głównym węzłem seed i dwoma workerami.
Analiza danych z Redash #
Do odpytywania Cassandry możesz użyć CQLSH (dostępnego na każdym węźle Cassandry, /opt/cassandra/bin) albo zainstalować Redash. To kompletna przeglądarka i wizualizator danych z możliwością podłączenia do wszystkich głównych RDBMS, a także do Cassandry. Aby zainstalować Redash, pobierz repozytorium https://github.com/getredash/setup i postępuj zgodnie z instrukcjami.
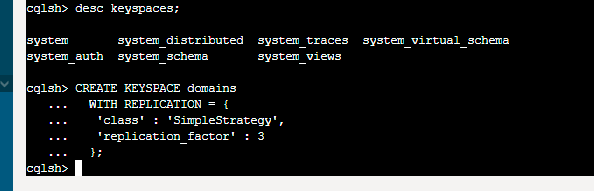
Aby zacząć zabawę z CQL (Cassandra Query Language), musimy zdefiniować keyspace (za pomocą CQLSH), czyli swego rodzaju bazę danych. Definiujemy go jako SimpleStrategy z 3 kopiami. Wszystkie nasze dane będą więc rozłożone na wszystkie węzły klastra. Dzięki temu będziemy odporni na awarie sprzętu lub sieci. W bardziej złożonych scenariuszach użyj NetworkTopologyStrategy ze zdefiniowanymi parametrami DC i Rack.
create keyspace domains
with replication = {
  'class: 'SimpleStrategy',
  'replication_factor': 3
};
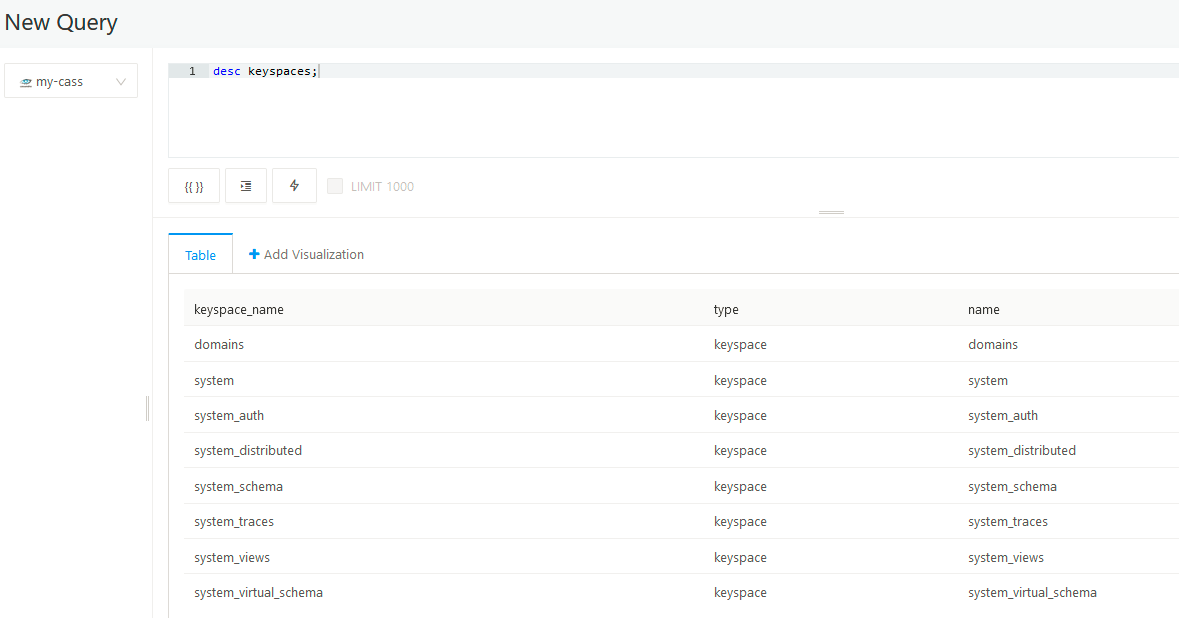
Teraz, gdy utworzyliśmy keyspace, możemy przejść do Redash i zdefiniować Data Source.
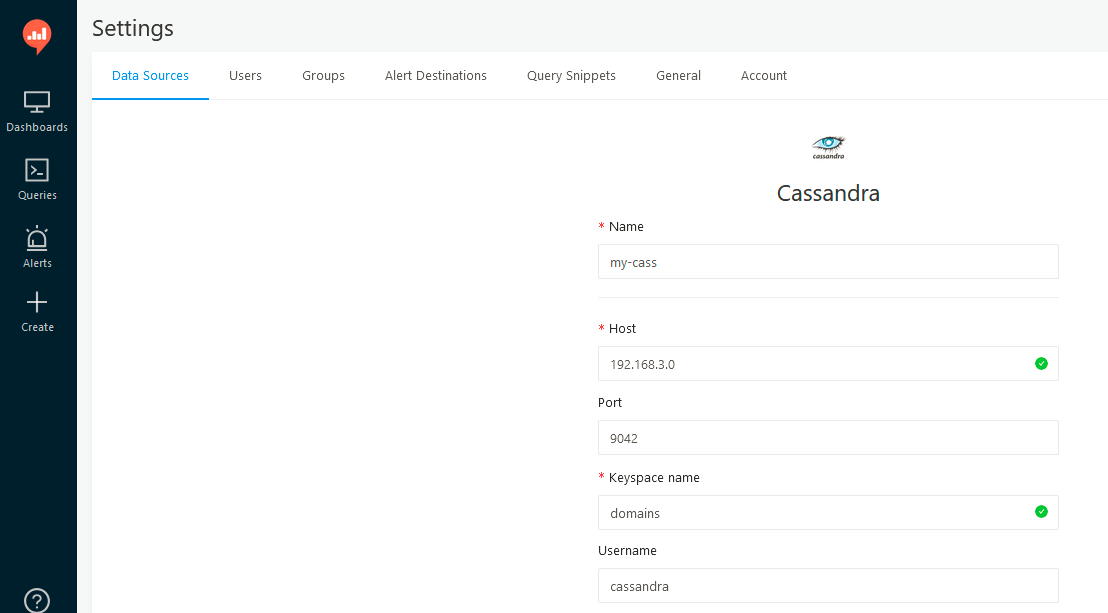
Następnie utwórz nowe zapytanie i eksperymentuj.
CQL DDL #
Utworzyliśmy już keyspace/bazę danych, więc czas utworzyć tabelę z jednokolumnowym kluczem głównym.
create table mylist
(
  myid int primary key,
  mytext text
)
W odpowiedzi Redash zwróci:
Error running query: 'NoneType' object is not iterableco oznacza, że Redash oczekuje obiektu iterowalnego, a zamiast tego nie dostał nic, bo tworzenie tabeli czy keyspace’ów nic nie zwraca.
CQL DML #
Cassandra ogranicza użytkownika, pozwalając odpytywać dane tylko wtedy, gdy klauzula odpowiada kolumnom klucza głównego.
insert into mylist (myid, mytext) values (1, 'test 1');
insert into mylist (myid, mytext) values (2, 'test 2');

select * from mylist where myid = 1;
select * from mylist where myid in (1,2);
Weźmy inny przykład:
create table myotherlist (
  myid int,
  myotherid int,
  mylastid int,
  primary key (myid, myotherid, mylastid)
);
Następnie wstawmy trochę danych:
insert into myotherlist (myid, myotherid, mylastid) values (1, 1, 1);
insert into myotherlist (myid, myotherid, mylastid) values (2, 2, 2);
insert into myotherlist (myid, myotherid, mylastid) values (3, 3, 3);
insert into myotherlist (myid, myotherid, mylastid) values (4, 4, 4);
A potem wypróbujmy różne kombinacje klauzuli where. Poniższe zapytanie zwróci błąd „column cannot be restricted as preceding column is not restricted”. Oznacza to, że nie ma osobnych indeksów, które pomogłyby zlokalizować te różne wartości kolumn. Zamiast tego wydaje się, że istnieje jakaś drzewiasta struktura indeksu (a konkretnie Log Structured Merge Tree), po której można przechodzić tylko z użyciem wszystkich kolejnych, sąsiadujących składników klucza głównego:
select * from myotherlist where mylastid = 1;Ale te zadziałają:
select * from myotherlist where myid = 1;
select * from myotherlist where myid = 2 and myotherid = 2;
select * from myotherlist where myid = 3 and myotherid = 3 and mylastid = 3;
Ponieważ klucz główny musi być unikalny, nie można wstawić tych samych wartości we wszystkich kolumnach, które już istnieją w tabeli. Co więcej, nie można pominąć żadnego z wymaganych kluczy klastrujących (myotherid i mylastid).

To samo dotyczy klucza partycji (myid):

Zasady projektowania #
W przeciwieństwie do RDBMS zasady projektowania w Cassandrze skupiają się bardziej na denormalizacji niż na normalizacji. Model danych musisz zaprojektować pod kątem tego, jak będziesz z niego korzystać, a nie tylko opisać schemat.
Natomiast w Cassandrze nie zaczynasz od modelu danych; zaczynasz od modelu zapytań
Porządek sortowania dostępny w zapytaniach jest stały i zależy wyłącznie od wyboru kolumn klastrujących podanych w poleceniu
CREATE TABLE
Przy projektowaniu relacyjnych baz danych często uczy się, jak ważna jest normalizacja. W pracy z Cassandrą nie jest to zaletą, bo działa ona najlepiej, gdy model danych jest zdenormalizowany.
Kluczowym celem, który dostrzeżesz, zaczynając tworzyć modele danych w Cassandrze, jest minimalizacja liczby partycji, które trzeba przeszukać, aby obsłużyć dane zapytanie. Ponieważ partycja jest jednostką przechowywania, która nie jest dzielona między węzły, zapytanie przeszukujące pojedynczą partycję zazwyczaj zapewnia najlepszą wydajność.
Przykładowa aplikacja i zrzucanie commitlogu #
Wcześniej zdefiniowałem tabelę myotherlist z trzema kolumnami całkowitoliczbowymi wchodzącymi w skład klucza głównego. Użyjmy Pythona, aby wstawić trochę danych. Najpierw zainstaluj sterownik:
pip3 install cassandra-driverNastępnie zdefiniuj program. Użyjemy prepared statements, bo oszczędzają cykle CPU.
import cassandra
print(cassandra.__version__)

from cassandra.cluster import Cluster

cluster = Cluster(['192.168.2.0', '192.168.2.1', '192.168.3.0'])
session = cluster.connect()

ret = session.execute("USE domains")

rangeofx = range(100)
rangeofy = range(100)
rangeofz = range(100)

stmt = session.prepare("INSERT INTO myotherlist (myid, myotherid, mylastid) values (?, ?, ?)");

for x in rangeofx:
    for y in rangeofy:
        for z in rangeofz:
            print(x, y, z)
            session.execute(stmt, [x, y, z])
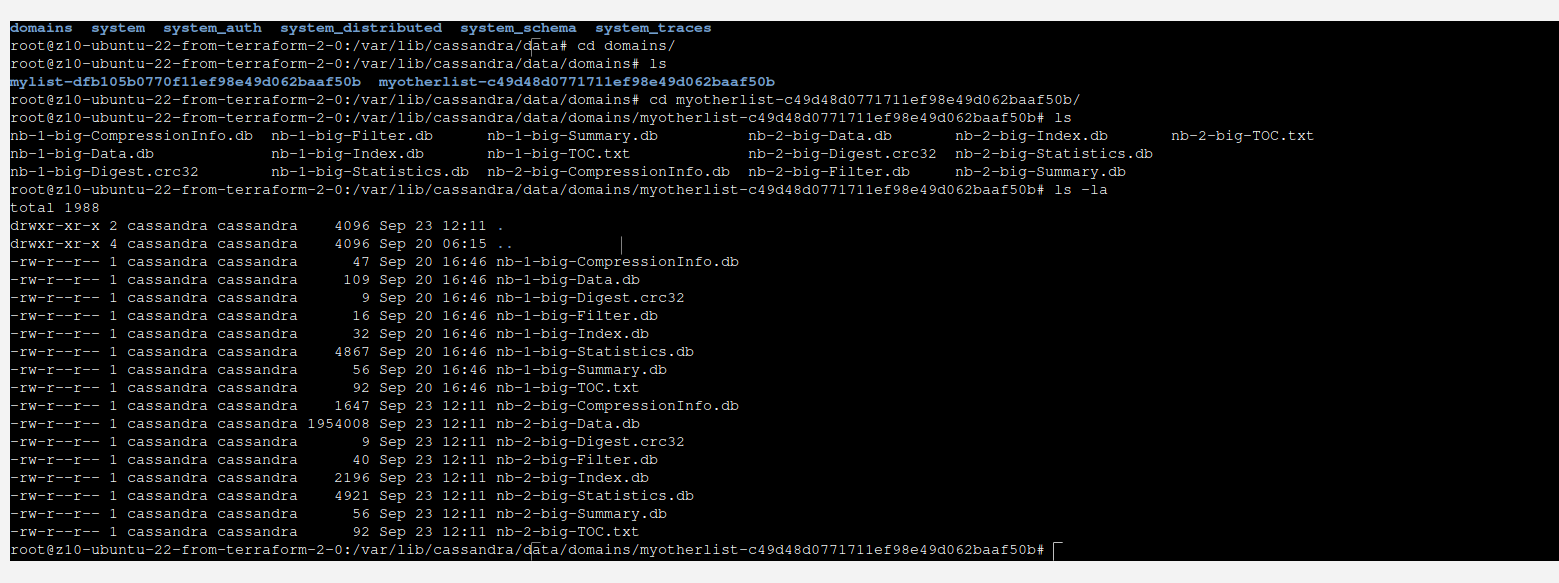
Co ciekawe, dane te nie pojawią się od razu w pliku danych. Zamiast tego trafią do commitlogu – przyjrzyjmy się:
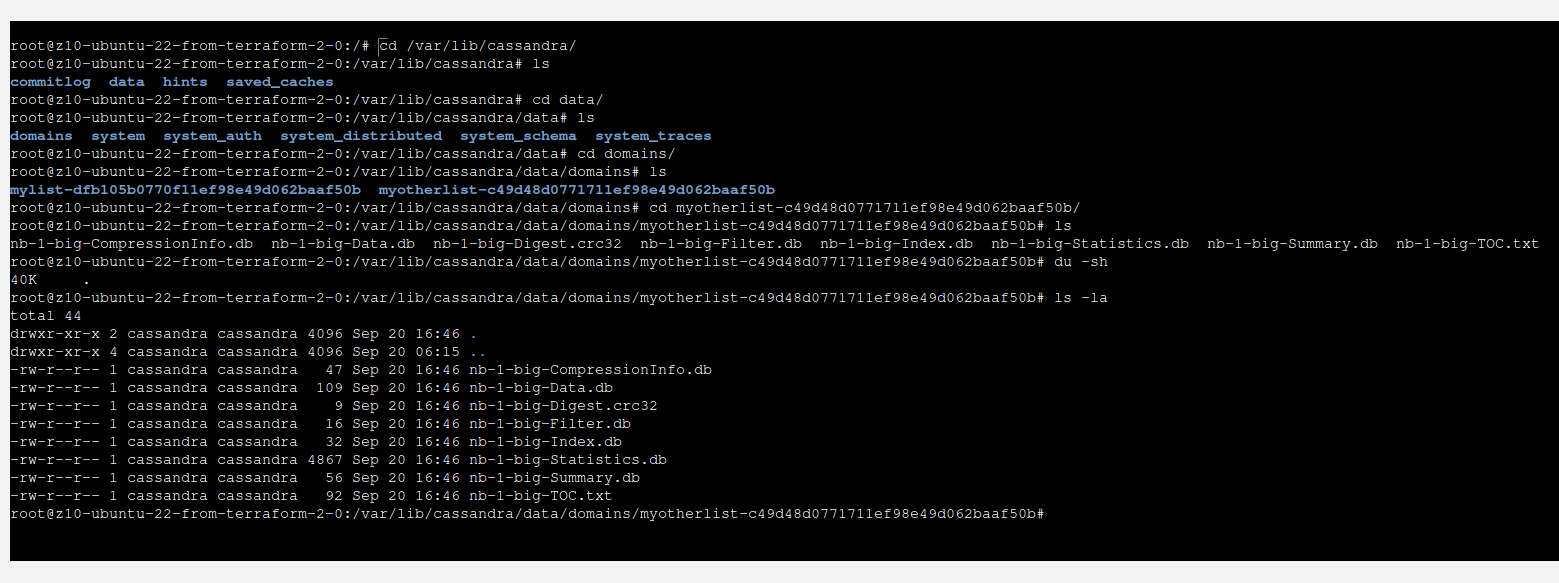
Jak widać, niewiele się tu dzieje. Gdy jednak zajrzymy do commitlogu, zobaczymy, że najprawdopodobniej to tam znajdują się nasze dane.
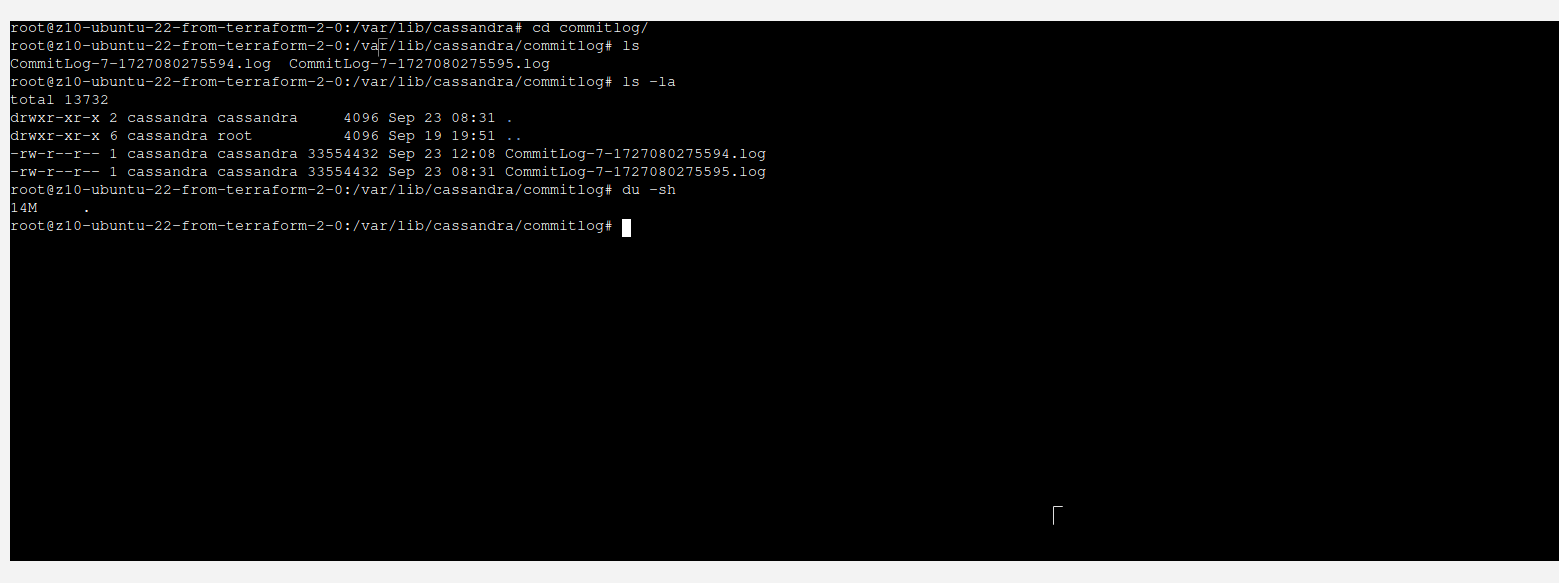
Aby zapisać dane do plików SSTable, uruchom ./nodetool flush. Spowoduje to przeniesienie zawartości pamięci i commitlogu do pliku danych.