Monitoring wideo z AI przy użyciu DeepStack, Pythona i ZoneMindera
Przetłumaczone automatycznie z angielskiego. Przeczytaj oryginał
Dla tych, którzy używają ZoneMindera i zastanawiają się, jak wykrywać obiekty, jest model AI deepquestai/deepstack z wbudowanym serwerem HTTP. Klatki wideo można pobierać przez API ZoneMindera lub API interfejsu:
https://ADDR/zm/cgi-bin/nph-zms?scale=100&mode=single&maxfps=30&monitor=X&user=XXX&pass=XXXTrzeba podać adres, ID monitora, użytkownika i hasło. Można też wskazać pojedynczą klatkę (mode=single) lub ruch (mode=jpeg). ZoneMinder wewnętrznie używa binarki /usr/lib/zoneminder/cgi-bin/nph-zms do pobierania klatki ze skonfigurowanej kamery IP ONVIF RTSP. Prawdopodobnie nie jest to najszybsza opcja, ale za to wygodna. Za pomocą OpenCV w Pythonie można by też odczytać strumień RTSP i pobierać klatki ręcznie. Jednak dla prostoty pozostaję przy nph-zms z ZoneMindera.
Powiedzmy, że mam taką klatkę wideo z kamery:
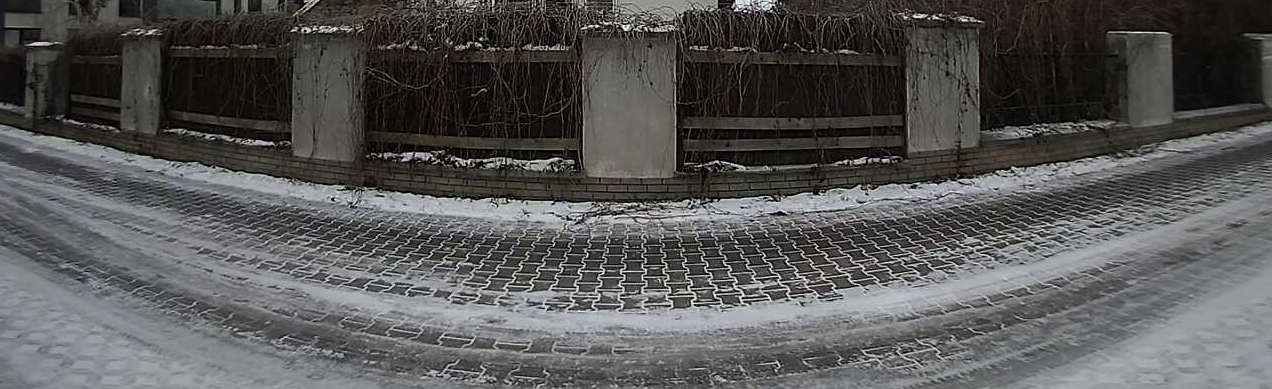
To prosty widok ulicy z betonowym ogrodzeniem, przez które biegną drewniane deski. Powiedzmy, że chciałbym wykrywać przejeżdżające i przechodzące obiekty. Najpierw musimy zainstalować sterowniki, runtime i uruchomić serwer.
Sterowniki NVIDIA #
W moim środowisku testowym mam RTX 3050 Ti z 4GB VRAM na Ubuntu 22 LTS w wersji desktop. Domyślnie sterowniki z CUDA 12.8+ nie będą dostępne. Można dostać wersję do 550. Począwszy od 525 dostępna jest CUDA 12.x. Ta karta graficzna ma architekturę Ampere z Compute Capabilities 8.6, co przekłada się na CUDA 11.5 – 11.7.1. Można jednak zainstalować sterowniki 570.86.16, które zawierają SDK CUDA 12.8.
sudo add-apt-repository ppa:graphics-drivers/ppa
sudo apt update
sudo apt install nvidia-driver-570
Aby sprawdzić, czy jest już załadowany:
lsmod | grep nvidiaObsługa GPU w Dockerze #
Natywna, domyślna instalacja Dockera nie obsługuje bezpośredniego użycia GPU. Według DeepStack należy uruchomić poniższe polecenia, aby skonfigurować runtime NVIDIA dla Dockera. ChatGPT sugeruje jednak instalację nvidia-container-toolkit. Rzetelne wyjaśnienie różnic znajdziesz tutaj. Na pierwszy rzut oka wygląda na to, że te pakiety są ze sobą powiązane.
curl -s -L https://nvidia.github.io/nvidia-docker/gpgkey | \
sudo apt-key add -
distribution=$(. /etc/os-release;echo $ID$VERSION_ID)
curl -s -L https://nvidia.github.io/nvidia-docker/$distribution/nvidia-docker.list | \
sudo tee /etc/apt/sources.list.d/nvidia-docker.list
sudo apt-get update
sudo apt-get install -y nvidia-docker2
sudo pkill -SIGHUP dockerd
Ponieważ zainstalowaliśmy nowy sterownik i przekonfigurowaliśmy Dockera, dobrze jest zrobić reboot. Po restarcie maszyny sprawdź, czy nvidia-smi raportuje właściwe wersje sterownika i SDK CUDA:
sudo docker run --gpus '"device=0"' nvidia/cuda:12.8.0-cudnn-devel-ubuntu22.04 nvidia-smiPowinno to wyświetlić wynik nvidia-smi uruchomionego z kontenera Docker o nazwie nvidia/cuda. Pamiętaj, że ten obraz może się nieco różnić, bo zmienia się z czasem. Flagę –gpus możesz dostosować, jeśli masz w systemie więcej niż jedną kartę graficzną obsługiwaną przez NVIDIA.
deepquestai DeepStack #
Aby uruchomić model DeepStack i serwer API z wykorzystaniem GPU, wystarczy podać tag gpu i ustawić flagę –gpus all. Jest też zmienna środowiskowa VISION-DETECTION ustawiona na True. Prawdopodobnie można skonfigurować też inne rzeczy, np. wykrywanie twarzy, ale na razie pozostanę tylko przy tej jednej:
sudo docker run --rm --gpus all -e VISION-DETECTION=True -v localstorage:/datastore -p 80:5000 deepquestai/deepstack:gpuMasz teraz działający kontener Docker z DeepStack z obsługą GPU. Przejdźmy do kodu programu.
Kod źródłowy mojego Vision AI #
import requests
from PIL import Image
import urllib3
from io import BytesIO
import time
urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)

prefix = "data-xxx/xxx"
zmuser = "readonly"
zmpass = "readonly"
zmaddr = "x.x.x.x"
zmmoid = x
deepstackaddr = "localhost:80"

#
# DOWNLOAD AND SAVE ZONEMINDER VIDEO FRAME
#
timestamp = int(time.time() * 1000)
url = "https://{}/zm/cgi-bin/nph-zms?scale=100&mode=single&maxfps=30&monitor={}&user={}&pass={}".format(zmaddr, zmmoid, zmuser, zmpass)
output_path = "{}_{}.jpg".format(prefix, timestamp)
response = requests.get(url, verify=False)
if response.status_code == 200:
    with open(output_path, "wb") as file:
        file.write(response.content)
    print(f"Downloaded: {output_path}")
else:
    print("Unable to download video frame")

#
# AI ANALYSE VIDEO FRAME
#
image_data = open(output_path,"rb").read()
image = Image.open(output_path).convert("RGB")
response = requests.post("http://{}/v1/vision/detection".format(deepstackaddr),files={"image":image_data},data={"min_confidence":0.65}).json()

#
# PRINT RECOGNIZED AND PREDICTED OBJECTS
#
for object in response["predictions"]:
    print(object["label"])
print(response)

#
# CROP OBJECTS AND SAVE TO FILES
#
i = 0
for object in response["predictions"]:
    label = object["label"]
    y_max = int(object["y_max"])
    y_min = int(object["y_min"])
    x_max = int(object["x_max"])
    x_min = int(object["x_min"])
    cropped = image.crop((x_min,y_min,x_max,y_max))
    cropped.save("{}_{}_{}_{}_found.jpg".format(prefix, timestamp, i, label))
    i += 1
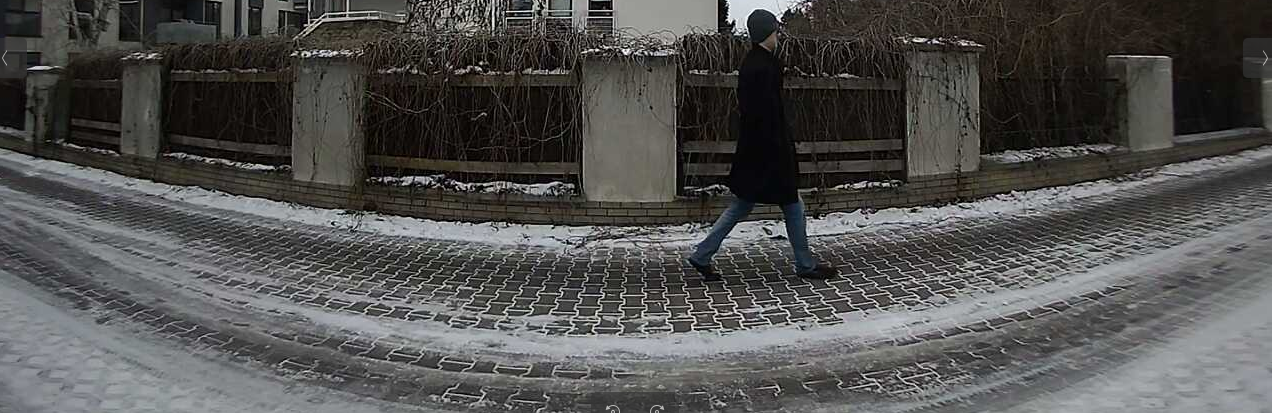
Tym kodem pobieramy klatkę wideo z ZoneMindera, zapisujemy ją lokalnie, przekazujemy do serwera API DeepStack w celu detekcji wizyjnej przez model i na koniec odbieramy przewidziane detekcje w postaci tekstowej oraz przycięte obrazy pokazujące wyłącznie wykryte obiekty. Przykładowo cała klatka wyglądała tak:
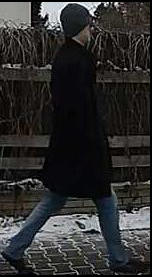
A program automatycznie wykrył i wyciął następujący obszar:
Ten model AI potrafi wykrywać kilka, a myślę, że kilkadziesiąt typów/klas obiektów. Jest już wstępnie wytrenowany i sądzę, że jest zamknięty, jeśli chodzi o douczanie i korygowanie detekcji. Oczywiście będę dalej zgłębiał ten temat. Może OCR tablic rejestracyjnych?